
GridDB SQLチューニングガイド
Revision: 6.0.0-1052
1 はじめに
1.1 本書の目的と構成
本書では、GridDBのSQLのチューニングについて説明します。
本書は、GridDBでSQLを用いたシステム開発を行う開発者の方を対象としています。
本書は、以下のような構成となっています。
チューニングのステップ
- SQLのチューニングのステップを説明します。
SQLの最適化
- SQLのスキャンやジョイン処理における最適化のルールを説明します。
SQLのプラン(実行計画)
- SQL最適化の結果であるプランについて説明します。
最適化のルールやチューニングなどについては、GridDBに特化した特徴的な点を主に説明します。
2 チューニングのステップ
SQLのチューニングは、一般的なデータベースシステムと同様に以下のような手順で行います。
STEP1 遅いクエリの確認
- システムにおいてSQLのパフォーマンスに問題がある場合、実行しているクエリの中で、時間がかかる遅いクエリを特定します。
STEP2 プランの取得
- 遅いクエリのプランを取得します。
STEP3 クエリのチューニング
- プランを分析して、意図した通りに動作しているかやクエリのどの部分に時間がかかっているかなどを確認します。
- 問題点に応じてクエリの書き換えや索引作成によって、クエリのチューニングを行います。
STEP4 クエリの再実行
- チューニングしたクエリを実行して性能を確認します。問題が解決していない場合は、再度STEP2から実施します。
STEP1からSTEP3について詳細を説明します。
2.1 遅いクエリの確認
システムで実行しているクエリの中で、時間がかかっている遅いクエリを特定します。
実行時間がかかった遅いクエリは、そのクエリと実行時間などの情報をイベントログに出力することができます。これにより、アプリケーションから実行された複数のクエリの中から、ボトルネックとなっているクエリを特定することができます。
遅いクエリの確認の手順は以下の通りです。
- スロークエリの出力設定を行う
GridDBノードに、スロークエリの実行時間の閾値とイベントログに出力するクエリ文字列のサイズ上限のパラメータがあります。
パラメータ 意味 デフォルト値 /sql/traceLimitExecutionTime スロークエリをイベントログに残す実行時間の下限値(単位:秒) 300s /sql/traceLimitQuerySize スロークエリに残るクエリ文字列のサイズ上限(単位:バイト) 1000 デフォルト値から変更する場合は、次の2つの方法のいずれかで設定します。
- ノードを停止して、ノード定義ファイル(gs_node.json)にパラメータを設定する
- 運用コマンドgs_paramconfを用いてオンラインで設定変更する (ただし、オンラインの設定変更はノード再起動によりリセットされます。設定変更を永続化するためには、オンラインで設定後、ノード定義ファイル(gs_node.json)にも設定してください。)
[メモ]
- SQLはクラスタ構成のいずれかのノードで実行されるため、スロークエリの出力設定は必ず全ノードに対して行ってください。
- gs_paramconfの使用方法は『GridDB 運用ツールリファレンス』(GridDB_OperationToolsReference.html)をご参照ください。
- クエリを実行する
- クエリを実行します。1で設定した実行時間を超えるクエリがイベントログに出力されます。
- 遅いクエリを確認する
スロークエリのログを確認します。確認方法は次の2つがあります。いずれかの方法でスロークエリを特定してください。
確認方法 内容 オンラインで最新の情報を確認する 運用ツールgs_logsのオプション--slowlogsを実行すると、スローログの情報を表示します。
・表示は、最新のイベントログファイルの情報のみです。
・イベントログファイルは、ファイルサイズが閾値を超えた場合、または日にちが変わった場合に切り替わります。切り替わると、gs_logsでは古いイベントログファイルの内容は表示されません。イベントログファイルを直接確認する ノードのイベントログファイルを直接確認します。
スロークエリのログは「SQL_LONG_QUERY」をキーワードにしてファイルから抽出してください。[メモ]
- SQLはクラスタ構成のいずれかのノードで実行されるため、必ず全ノードのスロークエリのログを確認してください。
- gs_logsの使用方法は『GridDB 運用ツールリファレンス』(GridDB_OperationToolsReference.html)をご参照ください。
2.2 プランの取得
STEP1で特定したスロークエリを実行して、クエリのプラン(グローバルプラン)を取得します。
プランの取得には運用ツールgs_shを用います。EXPLAIN ANALYZE構文でクエリを実行し、サブコマンドgetplantxtでプランを取得します。
(1) クエリを「EXPLAIN ANALYZE」構文で実行する
gs[public]> sql EXPLAIN ANALYZE select * from table1, table2 where table1.value=1 and table1.id=table2.id ;
検索を実行しました。 (19 ms)
(2) プランを取得する
gs[public]> getplantxt
Id Type       Input Rows Lead time Actual time Node                 And more..
--------------------------------------------------------------------------------------------------------------------
 0 SCAN       -     -           30          30 192.168.15.161:10001 table: {table1}
 1   SCAN     0     3000        21          21 192.168.15.161:10001 table: {table1, table2} INDEX SCAN JOIN_EQ_HASH
 2     RESULT 1     14           0           0 192.168.15.161:20001
GridDBでは、SQLに対して以下のように処理を行います。ノードはクエリを構文解析しプランを生成します。プランは実行単位であるタスクごとのプランから構成されており、各ノードは割り当てられたタスクを実行します。
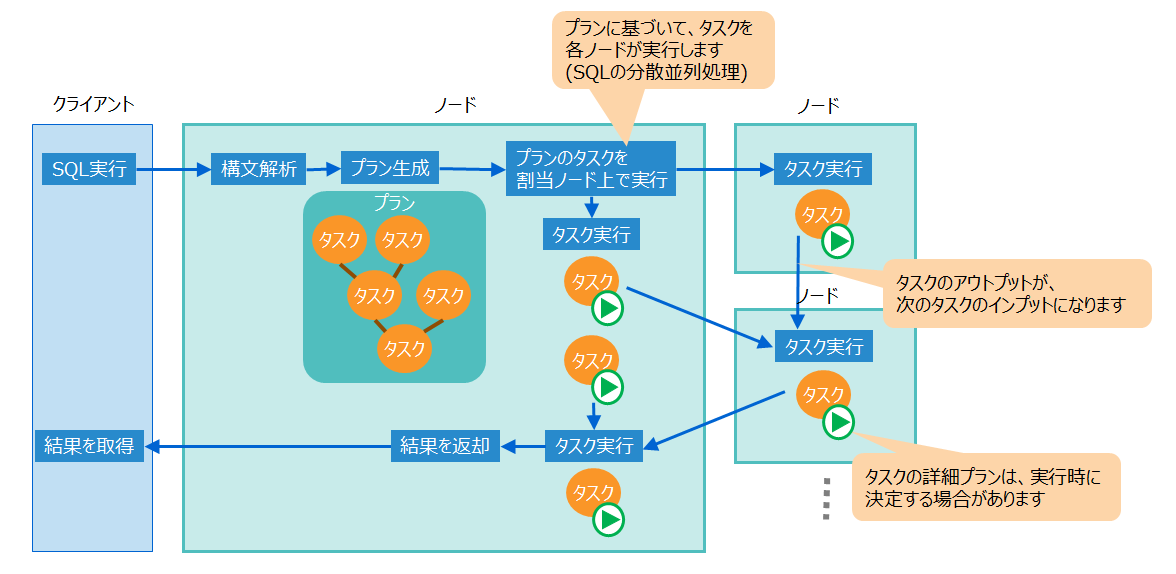
プラン表示のサブコマンドgetplantxtでは、このタスク単位のプランが1行ずつ表示されます。タスクの出力が次のタスクの入力になります。
「(2) プランを取得する」の実行例で、具体的にプランの表示を説明します。
- プランID1の「Input」は「0」なので、プランID0の結果を入力とします。
- プランID1の「Rows」は「3000」なので、プランID0から入力のロウ数は3000です。
- プランID1の「Node」は「192.168.15.161:10001」なので、このタスクはノード「192.168.15.161」で実行されました。
2.3 クエリのチューニング
WHERE句の絞り込み条件のスキャン処理や、テーブルのジョインのためのスキャン処理では、索引の利用有無によって大きく性能が変わる場合があります。また、テーブルのジョインの場合は、結合順序などによっても大きく性能が変わります。よって、これらをポイントにクエリのチューニングを行ってください。
(1) プランの分析
プランを分析して、索引の利用有無や意図したとおりに動作しているかを確認します。プランの詳細はSQLのプランをご参照ください。
索引の利用有無の確認方法
- WHERE句の絞り込み条件のスキャン処理や、テーブルのジョインのためのスキャン処理では、索引の利用有無によって大きく性能が変わる場合があります。
- 遅いタスクの「Type」が「SCAN」の場合は、そのスキャン処理で索引を利用しているかどうかを確認します。
- 索引を利用している場合は、「And mode..」に「INDEX SCAN」と表示されます。表示されない場合は、索引を使用していません。
(2) チューニング
プランの分析による問題点に応じて、次のような方法でチューニングを行います。
索引作成
- 索引が必要なカラムに索引がついていなかった場合は、索引を作成します。
- ただし、次のようなケースでは索引の効果が低いため、索引は作成しないことを推奨します。
- カラムのカーディナリティが低い(カラムの値の種類がロウ数に比べて少ない)など、クエリ実行で索引を使用してもほとんど値を絞り込むことができない場合
クエリの書き換え
- SQLの最適化に基づき、WHERE句の絞り込み条件やジョインの結合順序などの記述を書き換えます
- ヒント句を使用します。例えば、索引が付いているのに利用していない、またはクエリによっては索引を利用しない方がいい場合などは、ヒント句によってプランを変更します。
例) テーブルのジョインを行うクエリで、チューニングの例を説明します。
table1とtable2をカラムvalueの値で結合するクエリについて、プランを取得します。
gs[public]> EXPLAIN ANALYZE select * from table1, table2 where table1.value=0 and table1.value=table2.value;
検索を実行しました。 (13 ms)
gs[public]> getplantxt
Id Type       Input Rows  Lead time Actual time Node                 And more..
-------------------------------------------------------------------------------------
 0 SCAN       -     -            20          20 192.168.15.161:10001 table: {table1}
 1 SCAN       -     -             9           9 192.168.15.161:10001 table: {table2}
 2   JOIN     0,1   10000,3000  891         891 192.168.15.161:20001 JOIN_EQ_HASH
 3     RESULT 2     32            2           2 192.168.15.161:20001
このプランでは、table1とtable2をそれぞれスキャンして、索引を使わずにジョインの処理を行っています。
テーブルの索引情報を確認すると、カラムvalueに索引が付いていなかったため、索引を作成します。
同じクエリを実行してプランを取得します。
gs[public]> EXPLAIN ANALYZE select * from table1, table2 where table1.value=0 and table1.value=table2.value;
検索を実行しました。 (7 ms)
gs[public]> getplantxt
Id Type       Input Rows Lead time Actual time Node                 And more..
--------------------------------------------------------------------------------------------------------------------
 0 SCAN       -     -           20          20 192.168.15.161:10001 table: {table1}
 1   SCAN     0     10000       80          80 192.168.15.161:10001 table: {table1, table2} INDEX SCAN JOIN_EQ_HASH
 2     RESULT 1     32           3           3 192.168.15.161:20001
プランID2で「INDEX SCAN」と表示されており、索引を使用したジョイン処理にプランが変わっています。
3 SQLの最適化
3.1 索引を利用したスキャン
テーブル全体から一部のデータを探すスキャン処理では、テーブルの全ロウにアクセスする「フルスキャン」よりも、テーブルの索引を用いてアクセスする「索引スキャン」の方が、多くの場合に高速です。
索引スキャンは、以下のような処理で利用されます。
- WHERE句の絞り込み条件に一致するデータを求める処理
- 集計関数を用いて最大値・最小値を求める処理
特に、WHERE句による絞り込み条件がテーブルのロウ数に対してヒット率が小さい(=データを大きく絞り込める)場合、索引スキャンの効果が高くなります。一方、ヒット率が高い場合や索引が適切に利用できない場合は、フルスキャンが選択されることもあります。
GridDBでは、索引スキャンの最適化方式として「ルールベース」と「コストベース」の2つの方式を選択できます。
ルールベース方式
あらかじめ定められたルール(例:主キーや先頭カラムの等価比較がある場合はその索引を選択)に従って、使用する索引が決定されます。SQL構文や索引の有無に応じて、最も単純なルールで索引スキャンまたはフルスキャンが選択されます。コストベース方式
テーブルや索引に格納された統計情報をもとに、複数の候補となる索引やフルスキャンのコストを比較し、最も効率的なスキャン方法を自動的に選択します。これにより、データ量や分布、クエリの内容に応じて最適な実行プランが選択されます。
GridDB V5.9以降では、コストベース最適化がデフォルトで有効となっており、従来のルールベース方式も設定やヒント構文によって選択可能です。どちらの方式が適用されているかは、クラスタ設定やSQLヒントで明示的に制御できます。
以降では、ルールベース方式とコストベース方式それぞれの特徴や動作について説明します。
なお、GridDB V6.0以降では、上記の索引スキャン(TREE索引を用いたスキャン)に加えて、列指向索引を用いたスキャンを選択できます。列指向索引を用いたスキャンは、参照するカラムを限定して読み出すことで、大量データに対するスキャンを高速化します。詳細は列指向索引を用いたスキャンを参照してください。
3.1.1 索引選択決定方法の設定
コストベースによる方法とルールベースによる方法のいずれを用いるかは切り替え可能で、以下のようにして設定できます。
- サーバのクラスタ設定(gs_cluster.json)にいずれの方法を用いるか設定できます。全てのSQLについて同じ決定方法になります。具体的な設定方法は『GridDB 機能リファレンス』(GridDB_FeaturesReference.html)を参照してください。
- ヒントを記述することでいずれの方法を用いるかを指定できます。ヒントを記述したSQL毎に決定方法を指定できます。具体的な記述方法はヒント句を参照してください。
【メモ】
- 索引選択の決定方法のデフォルトは、コストベースによる方法です。
3.1.2 コストベースによる方法
3.1.2.1 索引の選択ルール(絞り込み条件の処理)
WHERE句の絞り込み条件を処理する際の索引選択ルールについて説明します。
指定された演算子や式によって、コストベース方式では以下のように判定します。
主キーやユニーク索引の等価比較
主キーやユニーク索引のカラムに対する等価比較条件(例:WHERE id = 100)が指定されている場合、該当する索引の利用が最優先で検討されます。ただし、他の索引候補やフルスキャンも含めて、統計情報(ヒット件数推定・索引密度など)をもとにコストを算出し、最も低コストな方法が選択されます。複数の索引候補が存在する場合
各索引について、ヒット件数推定やデータ分布などの統計情報をもとに、索引スキャンとフルスキャンのコストを比較し、最も効率的な方法を自動的に選択します。単一の索引だけでなく、複数の索引候補やフルスキャンも含めて総合的に評価されます。
AND
AND条件が複数指定されている場合、各条件に対応する索引候補やフルスキャンについて、統計情報(ヒット件数推定やデータ分布など)をもとにコストを算出し、すべての組み合わせの中から最も低コストとなる索引またはフルスキャンを自動的に選択します。
例)
a>1 AND b=2 (aとbに索引あり)
- aの索引、bの索引、フルスキャンのいずれも候補となり、統計情報に基づくコスト評価の結果、最も効率的な方法が選択されます。
例外的に、定数falseのOR条件"OR false"が付与されている場合や、索引利用不可と判定された場合は、他の条件の索引やフルスキャンが選択されます。
例)
(a>1 OR false) AND b=2 (aとbに索引あり)
- aの索引は利用不可と判定された場合、bの索引またはフルスキャンのコストを比較し、最適な方法が選択されます。
(a>1 AND b=2) OR false    (aとbに索引あり)
a>1 AND b=2 OR false      (aとbに索引あり)
- a、bの索引がともに利用不可と判定された場合、フルスキャンが選択されることがあります。
AND条件内にORやINが含まれている場合も、各組み合わせごとにコスト評価を行い、最も効率的な索引またはフルスキャンが選択されます。
例)
(a=1 OR a=3) AND b=2   (aとbに索引あり)
a IN (1,3) AND b=2     (aとbに索引あり)
- aの索引、bの索引、フルスキャンのコストを比較し、最適な方法が選択されます。
例)
(a=1 OR a=3 OR false) AND b=2   (aとbに索引あり)
(a IN (1,3) OR false) AND b=2   (aとbに索引あり)
- aの索引が利用不可と判定された場合、bの索引またはフルスキャンのコストを比較し、最適な方法が選択されます。
同一カラムに対する条件が重複する場合も、条件をマージしたうえで、コスト評価を行います。
例)
a>1 AND a<=4 AND a<=3 (aに索引あり)
- 条件"1<a<=3"にマージし、aの索引スキャンとフルスキャンのコストを比較して最適な方法が選択されます。
OR
OR条件が含まれている場合、各条件ごとに索引スキャンやフルスキャンの候補を洗い出し、それぞれの条件に対して統計情報(ヒット件数推定やデータ分布など)をもとにコストを算出します。すべての候補の中から、最も低コストとなる索引またはフルスキャンが自動的に選択されます。
例)
a>1 OR b=2 (aとbに索引あり)
- aの索引、bの索引、フルスキャンのコストを比較し、最適な方法が選択されます。
a>1 OR b=2 (bに索引あり)
- aに索引が設定されていない場合、bの索引またはフルスキャンのコストを比較し、最適な方法が選択されます。
比較演算子の式
比較演算子の値にカラム単独の式と定数式を用いる場合のみ、索引を使用します。
例)
a>10*1000-1 (aに索引あり)
- aの索引スキャンとフルスキャンのコストを比較し、最適な方法が選択されます。
例)
a+1>10*1000-1 (aに索引あり)
- aの索引は利用不可と判定された場合、フルスキャンが選択されます。
例)
a>b (aとbに索引あり)
- a、bの索引がともに利用不可と判定された場合、フルスキャンが選択されます。
IN、BETWEEN
INやBETWEENは、ANDやOR、比較演算子を組み合わせた式とみなしたうえで、上記のコストベースルールを適用します。
例)
a IN (1,2)        → a=1 OR a=2      (aに索引あり)
a BETWEEN 1 AND 2 → a>=1 AND a<=2   (aに索引あり)
- いずれの場合も、aの索引スキャンとフルスキャンのコストを比較し、最適な方法が選択されます。
[メモ]
索引スキャンで使用する索引は、NoSQLまたはNewSQLインタフェースで作成したTREE索引、または主キーに自動的に設定されるTREE索引のみです。NoSQLインタフェースで作成したHASH索引や空間索引は使用しません。
SQL構文のヒント「NoIndexScan」を用いると、索引を使用しないスキャンが指定できます。ヒントの詳細は「ヒント句」をご参照ください。
3.1.2.2 索引の選択ルール(最大値・最小値を求める処理)
集計関数で最大値・最小値を求める際の索引選択ルールについて説明します。
SELECT句のカラム式リストにおいて、索引が設定されたカラムを集計対象とするMIN関数やMAX関数を演算する場合、コストベース方式では、索引スキャンとフルスキャンのコストを比較し、統計情報をもとに最適な方法が自動的に選択されます。
集計関数と定数式を組み合わせた式のみを含む場合も同様です。
[メモ]
- WHERE句を含むSQLの場合、この最適化が行われるのは、絞込み条件が「集計対象カラムに関する大小比較式」または「常に真と評価される式」の組み合わせとなる場合に限ります。
その他の条件が含まれる場合には、索引スキャンとフルスキャンのコストを比較し、最適な方法が選択されます。 - 対象のテーブルがパーティショニングテーブルの場合は、索引選択ルールはデータパーティションごとに適用されます。
- 対象のテーブルがインターバルパーティショニングテーブルやインターバルハッシュパーティショニングテーブルの場合、個々のデータパーティション全体が含まれるような絞り込み条件式は「常に真と評価される式」とみなされます。
例)
SELECT MIN(a)         FROM table1            (aに索引あり)
SELECT MAX(a)         FROM table1 WHERE a<10 (aに索引あり)
SELECT MAX(a)-MIN(a)  FROM table1            (aに索引あり)
- aの索引スキャンとフルスキャンのコストを比較し、最適な方法が選択されます。
例)
SELECT MIN(a), MAX(b) FROM table1 (a、bに索引あり)
- a、bそれぞれの索引スキャンとフルスキャンのコストを比較し、最適な方法が選択されます。
例)
SELECT MAX(a)         FROM table1 WHERE a=10 (aに索引あり)
SELECT MAX(a)         FROM table1 WHERE b<10 (aに索引あり、パーティショニング設定なし)
SELECT MIN(a), SUM(a) FROM table1            (aに索引あり)
SELECT MIN(a), MAX(b) FROM table1 WHERE a<10 (a、bに索引あり)
- aやbの索引が利用不可と判定された場合、フルスキャンが選択されることがあります。
例)
SELECT MAX(a)         FROM table1 WHERE b>=TIMESTAMP('2024-01-01T00:00:00Z')
(aに索引あり、bは1日インターバルのパーティショニングキー)
- aの索引スキャンとフルスキャンのコストを比較し、各データパーティションのスキャン処理について最適な方法が選択されます
3.1.2.3 複合索引の選択ルール
GridDBのSQL最適化において、スキャン処理で使用する複合索引の選択ルールは、絞り込み条件に指定されたカラムや演算子によって、索引を使用する範囲が異なります。
コストベース方式では、複合索引を構成するカラムの先頭からAND条件で連続して指定されたカラムの条件までを複合索引として利用し、各パターンごとに統計情報(ヒット件数推定やデータ分布など)をもとにコストを算出し、最適な方法が自動的に選択されます。
[メモ]
- OR条件が入ると、それ以降の条件は複合索引として使用しません。
- SQLのカラム記述順は複合索引利用有無に影響しません。
- カラム値を関数で処理した値を条件比較する場合、索引は利用されません。
例)
where col1 = 1 and col2 = 1 and col3 = 2 (col1,col2,col3の複合索引あり)
- col1, col2, col3の複合索引スキャンとフルスキャンのコストを比較し、最適な方法が選択されます。
例)
where col1 = 1 and col2 > 1 and col3 < 2 (col1,col2,col3の複合索引あり)
- col1, col2, col3の複合索引スキャンとフルスキャンのコストを比較し、最適な方法が選択されます。
例)
where col1 = 1 and col2 = 1 (col1,col2,col3の複合索引あり)
- col1, col2の複合索引スキャンとフルスキャンのコストを比較し、最適な方法が選択されます。
例)
where col1 = 1 and col3 = 2 (col1,col2,col3の複合索引あり)
- col1の単独索引スキャンやフルスキャンのコストを比較し、最適な方法が選択されます(第二カラムcol2の指定がないため)。
例)
where col2 = 1 (col1,col2,col3の複合索引あり)
- 複合索引は利用されず、col2の単独索引やフルスキャンのコストを比較し、最適な方法が選択されます(第一カラムcol1の指定がないため)。
例)
where col1 = 1 and (col3 >= 0 and col3 < 10) and col2 = 1 (col1,col2,col3の複合索引あり)
- col1, col2, col3の複合索引スキャンとフルスキャンのコストを比較し、最適な方法が選択されます。
例)
where col1 = 1 and (col3 = 0 or col3 = 1) and col2 = 1 (col1,col2,col3の複合索引あり)
- col1, col2の複合索引スキャンやフルスキャンのコストを比較し、最適な方法が選択されます。
例)
where (col1 = 0 or col1 = 1) and col2 = 1 (col1,col2,col3の複合索引あり)
- col1の単独索引スキャンやフルスキャンのコストを比較し、最適な方法が選択されます。
例)
where col1 = 1 and (col3 >= 0 and col3 < 10) and ABS(col2) = 1 (col1,col2,col3の複合索引あり)
- col1の単独索引スキャンやフルスキャンのコストを比較し、最適な方法が選択されます(関数条件が含まれるため)
3.1.3 ルールベースによる方法
3.1.3.1 索引の選択ルール(絞り込み条件の処理)
WHERE句の絞り込み条件を処理する際の索引選択ルールについて説明します。
指定された演算子や式によって、ルールが異なります。
AND
基本的に、絞込み条件のカラムに索引が設定されている場合は先頭の索引を使用します。
例)
a>1 AND b=2 (aとbに索引あり)
- aの索引を使用します。
ただし、例外的に先頭の索引を使用しない場合もあります。例を以下に示します。
定数falseのOR条件"OR false"を付けると、索引を使用しません。
スキャンで索引を使用したくない場合は、この構文を指定してください。
例) 「a>1 AND b=2」で、aの索引を使用したくない場合
(a>1 OR false) AND b=2 (aとbに索引あり)- aの索引は使用しません。bの索引を使用します。
例) 「a>1 AND b=2」で、aとbの索引を使用したくない場合
(a>1 AND b=2) OR false (aとbに索引あり) a>1 AND b=2 OR false (aとbに索引あり)- aとbの索引は使用しません。
AND条件内にORやINが含まれている場合は、索引利用可能な先頭の式(最も左側の式)でのみ索引を使用します。
例)
(a=1 OR a=3) AND b=2 (aとbに索引あり) a IN (1,3) AND b=2 (aとbに索引あり)- aの索引を使用します。bの索引は使用しません。
例)
(a=1 OR a=3 OR false) AND b=2 (aとbに索引あり) (a IN (1,3) OR false) AND b=2 (aとbに索引あり)- ANDの左辺の式は、定数falseのOR条件が付いていて索引利用できないので、索引利用可能な右辺のbの索引を使用します。
なお、同一カラムに対する条件が重複する場合は、条件をマージして索引を使用します。
例)
a>1 AND a<=4 AND a<=3 (aに索引あり)
- 条件"1<a<=3"にマージして、aの索引を使用します。
OR
ORの場合は、絞込み条件に指定したカラムに、すべて索引が設定されている場合にのみ索引を使用します。
例)
a>1 OR b=2 (aとbに索引あり)
- aとbの索引を使用します。
例)
a>1 OR b=2 (bに索引あり)
- aに索引が設定されていないので、aとbの両方とも索引を使用しません。
比較演算子の式
比較演算子の値にカラム単独の式と定数式を用いる場合のみ、索引を使用します。
例)
a>10*1000-1 (aに索引あり)
- aの索引を使用します。
例)
a+1>10*1000-1 (aに索引あり)
- aの索引は使用しません。
例)
a>b (aとbに索引あり)
- aとbの索引は使用しません。
IN、BETWEEN
INとBETWEENは、ANDとORと比較演算子を組合せた式とみなしたうえで、上記のルールを適用します。
例)
a IN (1,2)        → a=1 OR a=2      (aに索引あり)
a BETWEEN 1 AND 2 → a>=1 AND a<=2   (aに索引あり)
- aの索引を使用します。
[メモ]
索引スキャンで使用する索引は、NoSQLまたはNewSQLインタフェースで作成したTREE索引、または、主キーに自動的に設定されるTREE索引のみです。 NoSQLインタフェースで作成したHASH索引や空間索引は使用しません。
SQL構文のヒント「NoIndexScan」を用いると、索引を使用しないスキャンが指定できます。ヒントの詳細は「ヒント句」をご参照ください。
3.1.3.2 索引の選択ルール(最大値・最小値を求める処理)
集計関数で最大値・最小値を求める際の索引選択ルールについて説明します。
SELECT句のカラム式リストにおいて、索引が設定されたカラムを集計対象とするMIN関数とMAX関数を演算する場合には、原則として索引を使用します。また、これらの集計関数と定数式を組み合わせた式のみを含む場合にも索引を使用します。
[メモ]
- WHERE句を含むSQLの場合、この最適化が行われるのは絞込み条件が以下の組み合わせとなる場合に限ります。その他の条件が含まれる場合には索引を利用しません。
- 集計対象のカラムに関する大小比較式
- 常に真と評価される式
- 対象のテーブルがパーティショニングテーブルの場合は、索引選択ルールはデータパーティションごとに適用されます。
- 対象のテーブルがインターバルパーティショニングテーブルかインターバルハッシュパーティショニングテーブルの場合、個々のデータパーティション全体が含まれるような絞り込み条件式は、「常に真と評価される式」とみなされます。
例)
SELECT MIN(a)         FROM table1            (aに索引あり)
SELECT MAX(a)         FROM table1 WHERE a<10 (aに索引あり)
SELECT MAX(a)-MIN(a)  FROM table1            (aに索引あり)
- 集計関数に基づく索引として、aの索引を使用します。
例)
SELECT MIN(a), MAX(b) FROM table1 (a、bに索引あり)
- 集計関数に基づく索引として、a、bの索引をそれぞれ使用します。
例)
SELECT MAX(a)         FROM table1 WHERE a=10 (aに索引あり)
SELECT MAX(a)         FROM table1 WHERE b<10 (aに索引あり、パーティショニング設定なし)
SELECT MIN(a), SUM(a) FROM table1            (aに索引あり)
SELECT MIN(a), MAX(b) FROM table1 WHERE a<10 (a、bに索引あり)
- 集計関数に基づく索引としては、aの索引を使用しません。
例)
SELECT MAX(a)         FROM table1 WHERE b>=TIMESTAMP('2024-01-01T00:00:00Z')
    (aに索引あり、bは1日インターバルのパーティショニングキー)
- 集計関数に基づく索引として、aの索引を使用します(各データパーティションのスキャン処理について)。
3.1.3.3 複合索引の選択ルール
GridDBのSQL最適化において、スキャン処理で使用する複合索引の選択ルールを説明します。
絞り込み条件に指定されたカラムや演算子によって、索引を使用する範囲が異なります。複合索引を構成するカラムの先頭よりAND条件で連続して存在するカラムの条件までを複合索引として使用します。
[メモ]
- OR条件が入ると、それ以降の条件は複合索引として使用しません。
- SQLのカラム記述順は複合索引利用有無に影響しません。
- カラム値を関数で処理した値を条件比較する場合、索引は利用されません。
例)
where col1 = 1 and col2 = 1 and col3 = 2 (col1,col2,col3の複合索引あり)
- col1,col2,col3の条件で複合索引を使用します。
where col1 = 1 and col2 > 1 and col3 < 2 (col1,col2,col3の複合索引あり)
- col1,col2,col3の条件で複合索引を使用します。
where col1 = 1 and col2 = 1 (col1,col2,col3の複合索引あり)
- col1,col2の条件まで複合索引を使用します。
where col1 = 1 and col3 = 2 (col1,col2,col3の複合索引あり)
- col1の条件まで複合索引を使用します。(第二カラムcol2の指定がないため)
where col2 = 1 (col1,col2,col3の複合索引あり)
- 複合索引を使用しません。(第一カラムcol1の指定がないため)
where col1 = 1 and (col3 >= 0 and col3 < 10) and col2 = 1 (col1,col2,col3の複合索引あり)
- col1,col2,col3の条件で複合索引を使用します。
where col1 = 1 and (col3 = 0 or col3 = 1) and col2 = 1 (col1,col2,col3の複合索引あり)
- col1,col2の条件まで複合索引を使用します。
where (col1 = 0 or col1 = 1) and col2 = 1 (col1,col2,col3の複合索引あり)
- col1の条件まで複合索引を使用します。
where col1 = 1 and (col3 >= 0 and col3 < 10) (col1,col2,col3の複合索引あり)
- col1の条件まで複合索引を使用します。
where col1 = 1 and (col3 >= 0 and col3 < 10) and ABS(col2) = 1 (col1,col2,col3の複合索引あり)
- col1の条件まで複合索引を使用します。
3.1.4 EXPLAIN ANALYZE 出力仕様(コストベース索引スキャン)
GridDBでは、EXPLAIN ANALYZE 実行時に、SQLプランおよび実行プロファイルをJSON形式で出力します。この中に、索引スキャン最適化に関するコスト評価情報が含まれます。
- 各プランノード・タスク実行プロファイルの
index項目に、候補索引と探索条件の組み合わせごとの情報がリスト形式で出力されます。 - 出力対象は、
SCAN_CONTAINER_INDEXオペレータに対応するプロファイルです。
構成要素
| 要素名 | 説明 |
|---|---|
name |
索引名。主キーなど名前を持たない索引やフルスキャンの場合は省略。 |
columnList |
索引を構成するカラム一覧。複合索引の場合は定義順に列挙。フルスキャンの場合は省略。 |
conditionList |
索引処理に使用される条件の一覧。各要素は { name: カラム名, condition: EQ/RANGE/FULL } |
actualTime |
索引処理の実行時間(ミリ秒)。コスト見積もりのみの場合も含む。 |
executionCount |
索引処理の実行回数。OR式や分割処理で複数回実行した場合は合計。見積もりのみの場合は省略。 |
hit |
索引処理でのヒット件数。見積もりのみの場合は省略。 |
cost |
索引処理コストの推定値(新規要素)。ヒット件数に基づく推定値。 |
estimationCount |
コスト見積もりの回数(新規要素)。OR式で複数回見積もりした場合は合計。 |
索引選択の判断要因
SCAN_CONTAINER_INDEXまたはSCAN_NO_INDEXEDオペレータに出力。criterion要素に、索引選択・非選択の判断要因がリスト形式で出力されます。
判断要因の種類
SYNTAX:構文解析で判定INDEX_NONE:利用可能な索引なし → フルスキャン選択INDEX_HIT:小規模読み出しで索引処理可能と判定INDEX_COST_SMALL:コスト見積もりで索引が最小コストと判定INDEX_COST_LARGE:コスト見積もりでフルスキャンが低コストと判定
出力例
{
  "profile": {
    "op": {
      "type": "SCAN",
      "op": {
        "type": "SCAN_CONTAINER_INDEX",
        "criterion": [ "INDEX_COST_SMALL" ],
        "index": [
          {
            "name": "idx_y",
            "columnList": [ "y" ],
            "conditionList": [ { "name": "y", "condition": "EQ" } ],
            "actualTime": 1,
            "executionCount": 2,
            "hit": 100000,
            "cost": 1000000,
            "estimationCount": 1
          },
          {
            "conditionList": [ { "condition": "FULL" } ],
            "cost": 50000000
          }
        ]
      }
    }
  }
}
3.1.5 列指向索引を用いたスキャン
GridDB V6.0で追加された列指向索引は、集計・分析などの分析系(DWH)クエリにおけるスキャン処理の高速化に利用できます。列指向索引を用いたスキャンでは、参照するカラムの列データを選択的に読み出すことで、参照しないカラムの読み出しに伴うI/Oを削減します。特に、多数のカラムを持つ大規模テーブルから、一部のカラムのみを参照するクエリで効果を発揮します。
列指向索引を用いたスキャンは、SQLの実行時に自動的に選択されます。まず、索引選択の方式(コストベース/ルールベース)に従って、従来型の索引(TREE索引)を用いたスキャンを選択するかどうかが判断されます。TREE索引を用いたスキャンが選択されない場合に、列指向索引を用いたスキャンが候補となります。索引選択の方式については、「索引選択決定方法の設定」を参照してください。
列指向索引を用いたスキャンの選択条件は、WHERE句の絞り込み条件の有無によって異なります。
- 絞り込み条件がある場合:絞り込み条件(AND条件)の先頭で参照するカラムが、列指向索引の対象に含まれていること。
- 絞り込み条件がない場合:SELECT句で参照するカラムのうち、常に出力されるカラムが、すべて列指向索引の対象に含まれていること。
上記の選択条件を満たしていれば、参照するカラムの一部が列指向索引の対象に含まれていなくても、列指向索引を用いたスキャンを選択できます。この場合、対象に含まれるカラムは列データから、対象に含まれないカラムはロウデータから読み出します。なお、対象カラムであっても、列データを利用できない範囲はロウデータから読み出します。
読み出した列データを展開して利用するのは、そのスキャン処理の実行中に限られます。ただし、展開に必要なメモリ量は、参照するカラムや処理対象のデータ量などによって異なります。
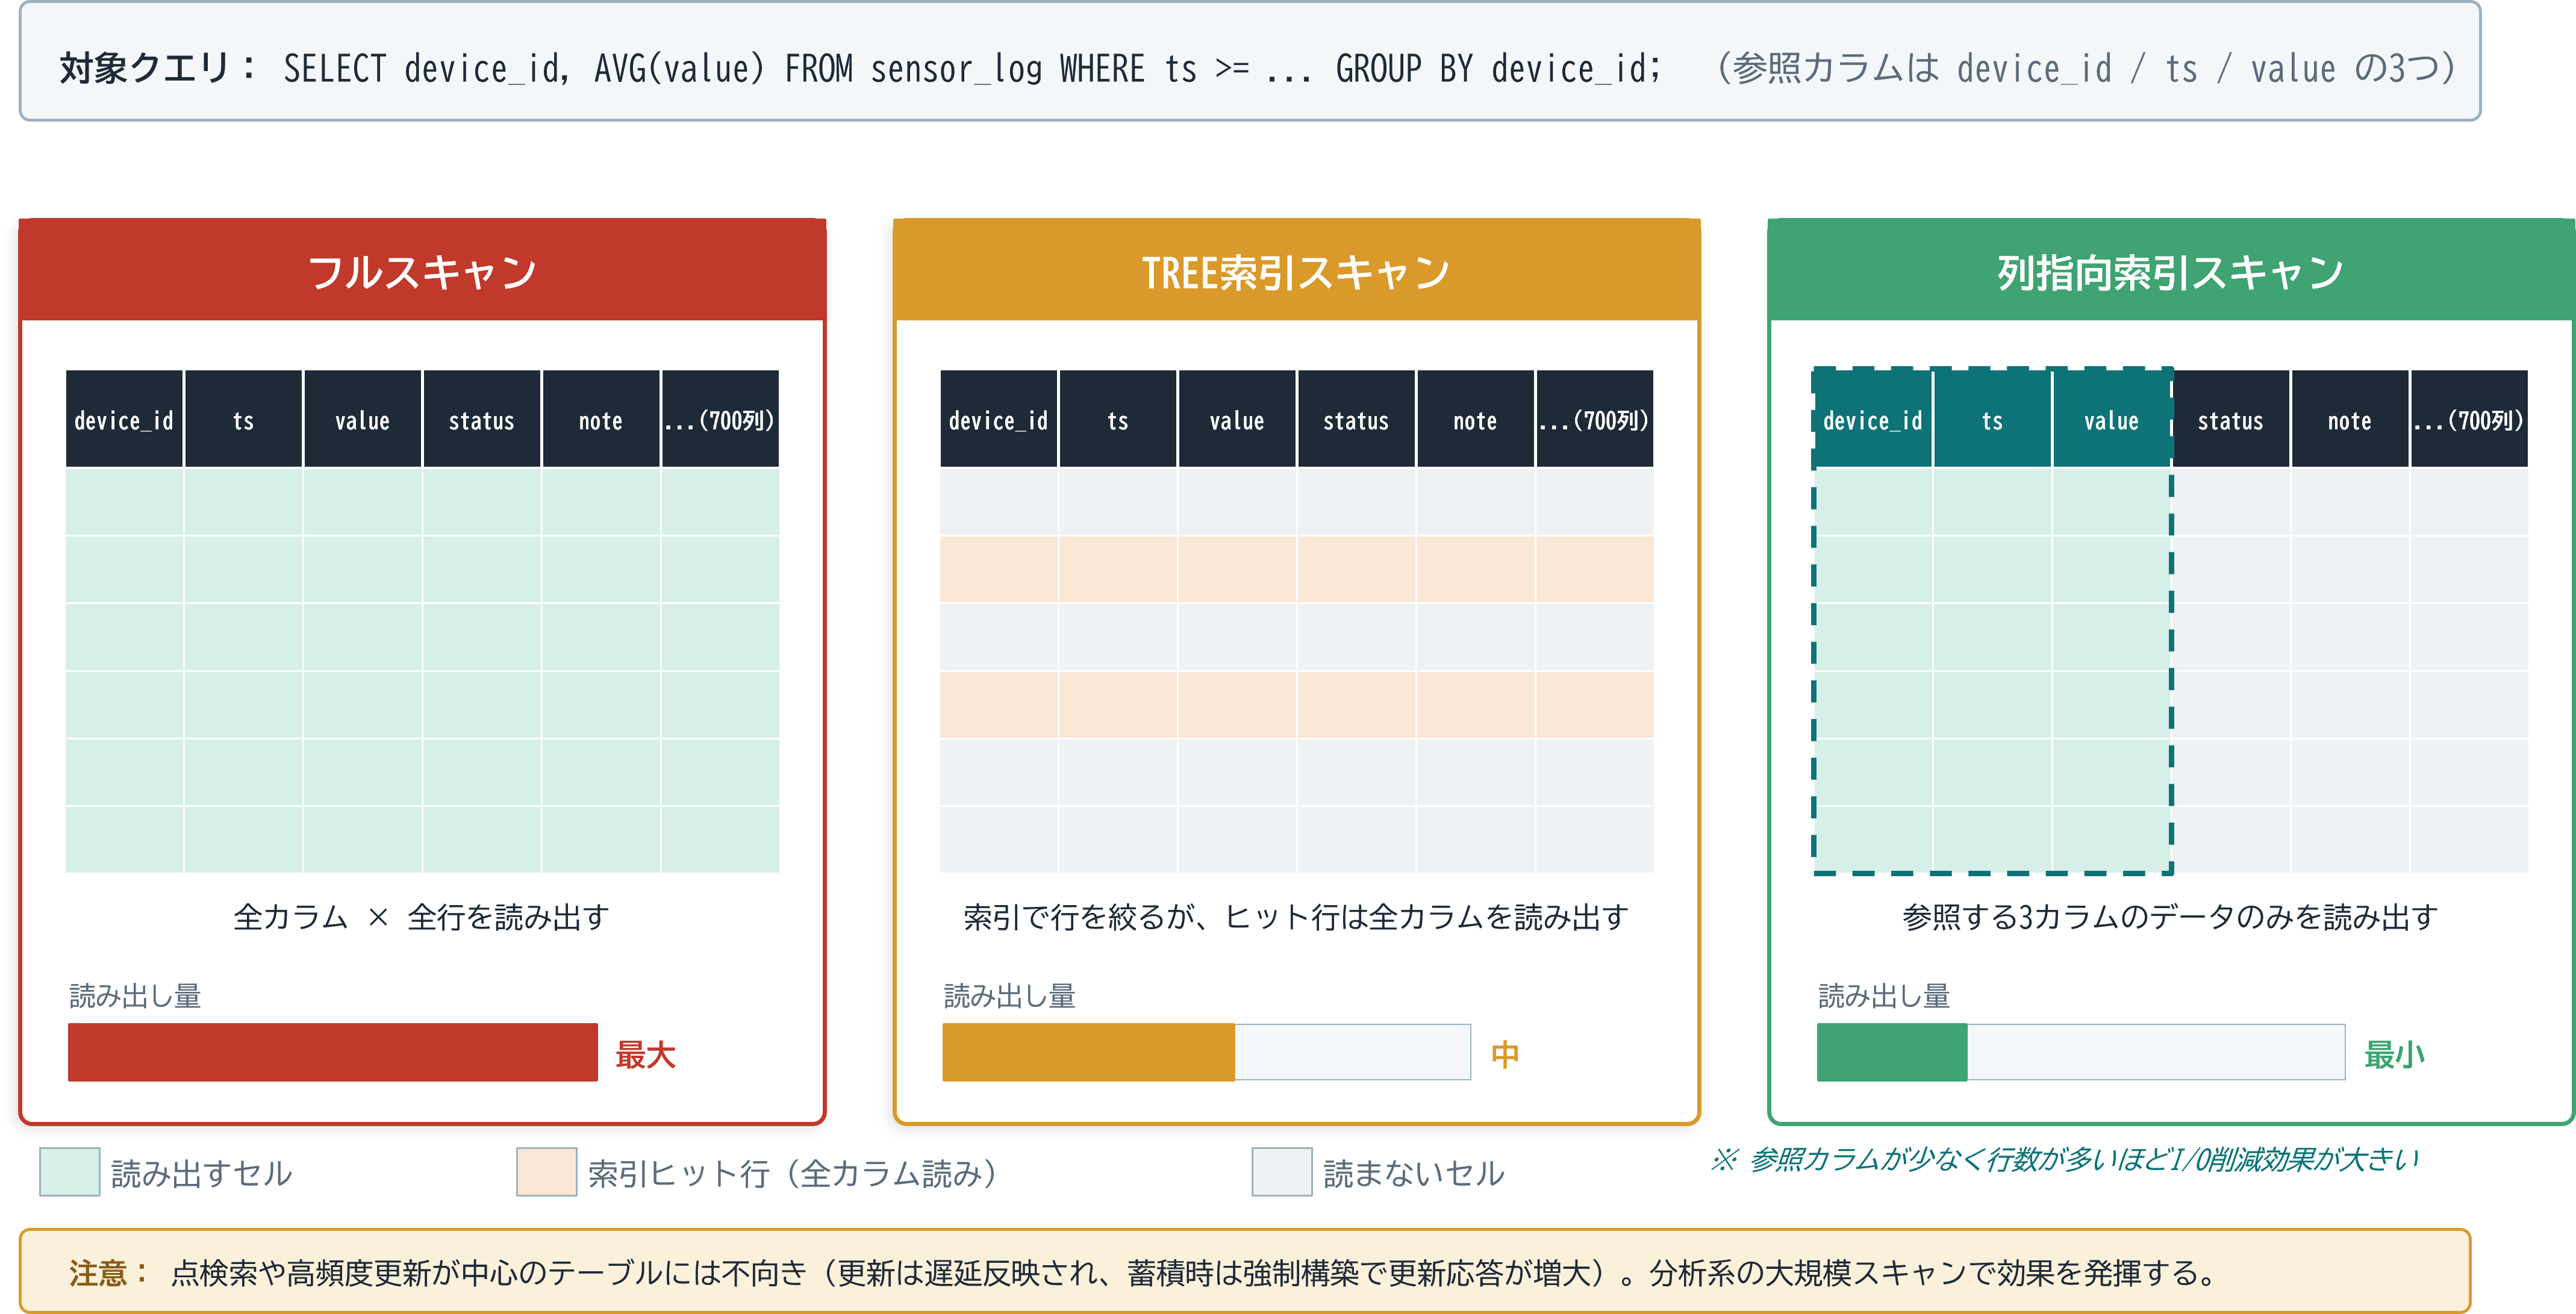
スキャン方式による読み出し範囲の違い
3.1.5.1 具体例
次のような多数のカラムを持つテーブルを例に説明します。カラム region と temperature に対して列指向索引を作成しているものとします。
CREATE TABLE sensor_data (
  ts TIMESTAMP, device_id STRING, region STRING,
  temperature DOUBLE, humidity DOUBLE, pressure DOUBLE
);
CREATE INDEX idx_col ON sensor_data USING COLUMNAR (region, temperature);
例1) 列指向索引を用いたスキャンが選択されるケース
WHERE句の先頭カラム region が列指向索引の対象であり、SELECT句の出力カラム region・temperature もすべて対象に含まれるため、列指向索引を用いたスキャンが選択されます。
例2) 一部のカラムがロウデータからの読み出しにフォールバックするケース
WHERE句の先頭カラム region が対象であるため列指向索引を用いたスキャンが選択されますが、出力カラムのうち humidity は列指向索引の対象外のため、humidity についてのみロウデータから読み出されます。
例3) 列指向索引を用いたスキャンが選択されないケース
WHERE句の先頭カラム humidity が列指向索引の対象外のため、列指向索引を用いたスキャンは選択されません。この場合、従来型の索引スキャンまたはフルスキャンが行われます。
列指向索引の作成方法、適用対象、更新の仕組みなどについては、『GridDB 機能リファレンス』(GridDB_FeaturesReference.html)の「列指向索引」を参照してください。
【メモ】
スキャン方式の選択と対象カラム
- 列指向索引を用いたスキャンは自動的に選択されます。列指向索引の使用を明示的に指定するヒントは提供されません。
- 列指向索引を用いたスキャンは、従来型の索引(TREE索引)を用いたスキャンが選択されない場合に候補となります。
NoIndexScanヒントなどでTREE索引を用いたスキャンを抑制すると、結果として列指向索引を用いたスキャンが選択される場合があります。ただし、このヒントで列指向索引の使用を強制することはできません。 - 列指向索引では、TREE索引の複合索引とは異なり、索引定義上の先頭カラムからの並びに制約されず、対象カラムの列データを読み出せます。同一テーブルに複数の列指向索引を定義した場合は、それらの対象カラムをまとめて、スキャン方式の選択条件が判定されます。分析系クエリで参照するカラムを列指向索引の対象に含めると、ロウデータからの読み出しを減らせます。なお、WHERE句のAND条件の先頭カラムに関する選択条件は、本文の説明に従います。
- CASE式やCOALESCE関数の引数など、条件によって評価されるカラムについても、列指向索引の対象に含まれる場合は列データから読み出します。
- スキャン方式は、SQL文全体で一律に決まるのではなく、テーブルまたはデータパーティションに対応するスキャンタスクごとに判断されます。
更新時の読み出しと性能への影響
- 更新内容が列指向索引に未反映の範囲でも、列データを利用できる場合は、変更差分を適用して読み出します。未構築・構築中などで列データを利用できない範囲は、ロウデータから読み出します。このため、更新が未反映のセグメントをすべてロウデータから読み出すわけではありません。また、索引への反映の遅れによって、更新内容が検索結果から欠落することはありません。
- 高頻度の更新や大量の更新が継続すると、バックグラウンドでの再構築が追いつかず、変更差分の処理やロウデータからの読み出しが増え、検索の高速化効果が小さくなる場合があります。また、バックグラウンド構築は業務処理とCPU・メモリ・I/Oを共有するため、その負荷が業務処理の応答時間に影響する場合があります。
性能の確認と構築設定の調整
列指向索引を用いたスキャンが選択されても、すべての対象範囲・カラムを列データだけから読み出すとは限りません。性能を確認する際は、次の情報をあわせて確認してください。
EXPLAIN ANALYZEのcolumnar要素による、実行時の列指向索引の利用状況#columnar_stats・#background_infoによる、索引の構築状況- 業務処理の応答時間と、CPU・メモリ・I/Oの利用状況
索引の構築状況を示す統計だけでは、個々の検索で列指向索引が利用されたかどうかは判断できません。
登録・更新処理とバックグラウンド構築の負荷が競合する場合は、次の設定の調整を検討してください。
/dataStore/columnarBuildDelay:再構築の開始を遅らせます。ただし、実行中の構築処理は中断しません。/dataStore/columnarSegmentMaxRows:1セグメントあたりの処理量を調整します。セグメントを小さくすると、セグメント管理やI/Oの増加、圧縮効率の低下を伴う場合があります。
既定値を基準に1項目ずつ変更し、登録性能、業務SQLの応答時間、索引の構築状況をあわせて確認してください。詳細は『GridDB 機能リファレンス』の登録・更新負荷を考慮した構築設定を参照してください。
適用対象外
- TQL(NoSQLインターフェース)には、列指向索引は適用されません。
3.1.6 EXPLAIN ANALYZE 出力仕様(列指向索引スキャン)
EXPLAIN ANALYZE を用いると、列指向索引を用いたスキャンが選択されたかどうかを確認できます。
- 列指向索引を用いたスキャンが選択された場合、実行プロファイルにカラムスキャンを示す
SCAN_CONTAINER_COLUMNオペレータが出力されます。 SCAN_CONTAINER_COLUMNオペレータには、列指向索引の利用状況を示すcolumnar要素が含まれます。- 列指向索引が使用されなかった場合は、従来どおり
SCAN_CONTAINER_INDEX(索引スキャン)、または索引を用いないスキャンのオペレータが出力されます。
出力例
{
  "profile": {
    "op": {
      "type": "SCAN",
      "op": {
        "type": "SCAN_CONTAINER_COLUMN",
        "columnar": { ... }
      }
    }
  }
}
columnar 要素の各フィールドの詳細については、『GridDB SQLリファレンス』(GridDB_SQL_Reference.html)を参照してください。
3.2 ジョイン
GridDBのSQL最適化において、複数テーブルのジョイン演算の実行の仕方を決定する方法について説明します。
-
- 複数テーブルをジョインする順序を決定します。
- 順序の決め方にはコストベースによる方法とルールベースによる方法の2通りの方法があります。
-
- ジョインの処理に索引を利用するかどうかをルールにより決定します。
-
- 索引適用ルールで索引を利用することが決まった場合に、どの索引を選択するかをルールにより決定します。
-
- ジョイン処理の演算方法をルールにより決定します。
索引を使用しないジョイン処理においては、ジョイン順序やジョイン演算方法の違いが性能に大きく影響します。
3.2.1 ジョイン順序の決定方法
SQL実行時、3つ以上のテーブルの結合がある場合、どのテーブルをどの順番でジョインするか順序を決める必要があります。順序の決め方には、コストベースによる方法とルールベースによる方法の2種類あります。いずれを用いるかは設定により選択できます。
3.2.1.1 順序決定方法の設定
コストベースによる方法とルールベースによる方法のいずれを用いるかは切り替え可能で、以下のようにして設定できます。
- サーバのクラスタ設定(gs_cluster.json)にいずれの方法を用いるか設定できます。全てのSQLについて同じ決定方法になります。具体的な設定方法は『GridDB 機能リファレンス』(GridDB_FeaturesReference.html)を参照してください。
- ヒントを記述することでいずれの方法を用いるかを指定できます。ヒントを記述したSQL毎に決定方法を指定できます。具体的な記述方法はヒント句を参照してください。
【メモ】
- ジョイン順序の決定方法のデフォルトは、コストベースによる方法です。
3.2.1.2 コストベースによる方法
コストベースによるジョイン順序の決定方法は、ジョイン演算を実行するコストが最も低いと推定される順序を決定する方法です。ここで用いるコストは、ジョインするテーブルやジョイン結果(中間結果)のロウ件数を推定で概算したものです。複数テーブルのジョインを行う場合、どのテーブルとどのテーブルを選んでジョインするか、どの順序でジョインするかなど、多くのジョイン演算の候補が考えられます。このジョイン演算の候補それぞれについて、入出力となるロウ件数を推定で概算し、SQL実行時にジョイン演算されるロウ件数が最も小さくなると推定したものを選んでいきます。演算するロウ件数が少ない方が高速に演算できるため、最終的に選ばれたものが最適なジョイン順序になります。
ジョイン出力のロウ件数概算値は、GridDBが以下の絞り込み度合いの強さの観点の各基準に従い評価することで、求められます。
- ジョイン演算自体の絞込み度合いの観点
- ジョイン結果の絞込み度合いの観点
絞込み度合いの判断には以下の評価基準が用いられます。
- 比較条件の種別に関する基準。以下の順番で絞込み度合いが強いと評価されます。
- 等値比較(=,IN)
- 大小比較(<,<=,>,>=,BETWEEN)
- 条件の論理積・和の構造に関する基準。以下の順番で絞込み度合いが強いと評価されます。
- 論理積(AND)結合の数(より多いほうが強い)
- 論理和(OR)結合の数(より多いほうが弱い)
[メモ]
もし絞込み度合いが同じジョイン演算の候補が複数あった場合、コスト(ロウ件数概算値)による順序決定ができないので、以下の優先度に従いジョインを先に実行する順序にします。
- ジョイン(部分木)に含まれるノードのロウ件数概算値の最大値が小さいほう
- ジョイン(部分木)に含まれるノード数が少ないほう
- SQLにより前に記述されたほう
コストベースによる方法とルールベースによる方法とでは、順序決定の判断基準が異なるため、ジョイン順序が異なることがあります。(ルールベースの詳細についてはルールベースによる方法を参照してください。)
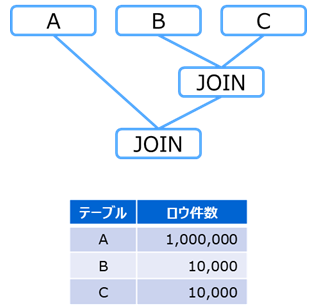
以下の3つのテーブル(A,B,C)の単純なジョインの例で違いを説明します。
例)
SELECT * FROM A,B,C
WHERE A.x = B.x AND B.y = C.y
コストべースによる方法の場合、与えられたSQLと各テーブルのロウ件数概算値を参照、解析します。この例では、テーブルAのロウ件数概算値がほかのテーブルと比較して桁違いに大きい状態です。この場合、テーブルAのジョイン演算はコストが大きいと判断されます。その結果、テーブルBとテーブルCのジョイン演算を先に実行し、最後にテーブルAに関するジョイン演算を行う、下図のようなジョイン順序のプランを生成します。
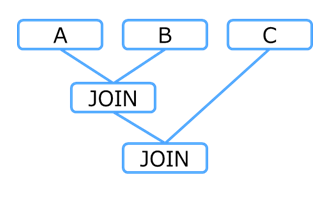
ルールベースによる方法の場合、与えられたSQLのみを解析してプランを生成します。例のSQLの場合、記述された順に従い、下図のようなジョイン順序のプランを生成します。ロウ件数が多いテーブルAのジョイン演算の出力は件数が多い可能性が高いですが、SQL文の記述に従い、その演算結果とテーブルCとのジョインを行うプランを生成します。
[メモ]
- コストベースによる方法の判断基準となるコストはあくまで推定値のため、コストベースによる方法で生成したプランがルールベースによる方法で生成したものより高速にならない場合があります。SQLを評価して、必要に応じてヒント句などによりチューニングすることを推奨します。
3.2.1.3 ルールベースによる方法
ルールベースによるジョイン順序の決定方法は、記述したSQLの結合や絞込み度合いの強さによって順序を決める方法です。
結合度合いの強いテーブルは、連続してジョインするような順番になります。
例)
FROM A, B, C- 何も指定が無い場合は、記述した順番になります。(AとBでジョイン、その結果とCでジョイン)
例)
FROM A, B, C WHERE A.x=C.z AND C.z=B.y- AとC間の結合度合いが高いため、A・C・Bの順番になります。(AとCでジョイン、その結果とBでジョイン)
例)
FROM A, B, C WHERE A.x>=C.z AND C.z>=B.y AND B.y=A.x- AとB間の結合度合いが高いため、A・B・Cの順番になります。(AとBでジョイン、その結果とCでジョイン)
絞込み度合いの強いテーブル(該当データ数が少ないと推定されるもの)ほど、ジョインの順番が先になります。
例)
FROM A, B, C WHERE A.x=C.z AND C.z=B.y AND B.x=1- Bの方が絞り込み度合いが強いため、B・C・Aの順番になります。
例)
FROM A, B, C WHERE A.x=C.z AND C.z=B.y AND A.x IN (1, 2) AND B.x IN (1, 2, 3)- Aの方が絞り込み度合いが強いため、A・C・Bの順番になります。
[メモ]
- SQL構文のヒント「Leading」を用いると、ジョインの順序を入れ替えることができます。ヒントの詳細はヒント句をご参照ください。
3.2.2 駆動表の選択
結合処理において、最初にアクセスするテーブルを駆動表、次にアクセスして結合するテーブルを内部表といいます。駆動表の決め方には、コストベースによる方法とルールベースによる方法の2種類あります。いずれを用いるかは設定により選択できます。
3.2.2.1 駆動表の選択方法の設定
コストベースによる方法とルールベースによる方法のいずれを用いるかは切り替え可能で、以下のようにして設定できます。
- サーバのクラスタ設定(gs_cluster.json)にいずれの方法を用いるか設定できます。全てのSQLについて同じ決定方法になります。具体的な設定方法は『GridDB 機能リファレンス』(GridDB_FeaturesReference.html)を参照してください。
- ヒントを記述することでいずれの方法を用いるかを指定できます。ヒントを記述したSQL毎に決定方法を指定できます。具体的な記述方法はヒント句を参照してください。
【メモ】
- 駆動表の選択方法のデフォルトは、コストベースによる方法です。
3.2.2.2 コストベースによる方法
コストベースによる駆動表の決定方法は、ジョイン演算を実行するコストが最も低いと推定される順序を決定する方法です。ここで用いるコストには、次の2種類があります。
中間出力コストジョイン演算の入力となりうる各プランノードにおける、中間結果の出力ロウ件数の推定規模です。推定される下限値・上限値と、それらの推定値の確度(確定or概算)により示されます。
スキャンコストジョイン演算の内部表となりうる各スキャンプランのノードにおける、データ読み出し量の推定規模です。
※プランノード: SQL実行プランの構成要素です。このプランノードは、SQL実行の際に、分散処理の基本単位(タスク)と一対一で対応します。プランノードの演算の種別としてはスキャンやジョインなどがあり、それぞれの種別や演算内容に応じた負荷見積もりは、ジョイン方向を定めるための基本的な判断材料として用いられます。
対象のジョイン演算に関わる中間出力コスト・スキャンコストを合わせた総コストについて、(ジョイン方向を定めない場合対比で)その削減効果が一定程度見込まれる場合にのみジョイン方向を定めることとし、かつ、総コストがより低くなる方を駆動表側とするよう判定します。
【メモ】
- この基準を用いることで、ジョイン演算や関係するスキャン演算の実コスト(処理時間・リソース量)を近似的に推定するものとします。絞り込み条件式や対応する索引、データ分布によって、推定コストと実コストの差異が変動することがあります。
- ルールベースによる方法の場合に存在する制約条件(例:内部表側テーブルに対する索引有無)には依存しません。
3.2.2.3 ルールベースによる方法
ジョインの順序(駆動表と内部表)は次のルールで決まります。
2つのテーブルの結合の場合、定数の等価絞込み条件があるテーブルが駆動表になります。両テーブル共に満たす場合は、先に記述された方を駆動表として判定します。
例)
t1.a=t2.x AND t2.y=1
- 定数1との絞込み条件があるt2が駆動表、t1が内部表になります。
3.2.3 索引適用の決定方法
ジョイン処理で索引を使用するかどうかのルールを説明します。
次の5つのすべてを満たす場合に索引を使用します。
駆動表側に等価絞込み条件がある
例)
t1.a=t2.x AND t2.y=1 (aに索引あり、駆動表はt2、内部表はt1)- 駆動表の絞込みが等価条件(t2.y=1)なので、ジョイン処理に索引を適用します。
例)
t1.a=t2.x AND t2.y>1 (aに索引あり、駆動表はt2、内部表はt1)- 駆動表の絞込みが等価条件ではない(t2.y>1)ので、ジョイン処理に索引を適用しません。
第一結合条件が等価結合条件である
例)
t1.a>t2.x AND t1.b=t2.y AND t2.z=1 (aに索引あり、駆動表はt2、内部表はt1)- 第一結合条件が等価結合条件ではない(t1.a>t2.x)ので、ジョイン処理に索引を適用しません。
第一結合条件の内部表側の等価結合条件カラムに索引が設定されている
例)
t1.a=t2.x AND t2.y=1 (aに索引なし、駆動表はt2、内部表はt1)- 第一結合条件の内部表側の等価結合条件カラムt1.aに索引が設定されていないので、ジョイン処理に索引を適用しません。
INNER JOINである
NoIndexJoinヒントで無効化されていない
【LEFTジョインでの索引適用について】
GridDB V6.0以降では、上記のINNER JOINにおける索引適用に加えて、LEFTジョイン演算においても索引を用いたジョイン処理が行われます。LEFTジョインでは、コスト判定基準を満たし、かつ右側の入力テーブルを内部表として選択できる場合に、内部表側の結合キーカラムに設定された索引を用いてジョイン対象を絞り込みます。
これにより、内部表(右側)が大規模であり、索引による絞り込みが有効に機能する場合に、全件スキャンと比較してI/O量およびメモリ消費を削減できます。
[メモ]
- ジョインの駆動表と内部表の選択は、Leadingヒントを用いて指定することができます。ヒントの詳細はヒント句をご参照ください。
- ジョインでの索引の適用有無は、IndexJoinヒント/NoIndexJoinヒントを用いて指定することもできます。ヒントの詳細はヒント句をご参照ください。
3.2.4 索引選択の決定方法
ジョインの構文が索引適用の決定方法に当てはまる場合、索引を使用してジョインを行います。ジョインで使用する索引を選択するルールを説明します。
基本的に、スキャンの索引の選択ルールと同様です。カラムに設定されている索引はすべて記述順に使用します。
すべての索引を使用しない場合もあります。例を以下に示します。
絞込み条件のカラムに索引が設定されている場合は先頭の索引を使用します。
例)
t1.a=t2.x AND t1.b>t2.y AND t2.z=1 (aとbに索引あり、駆動表はt2、内部表はt1)
- aの索引のみを使用します。
OR条件(A OR B)において、Bがfalse定数の場合、Aの索引は使用しません。
例)
t1.a=t2.x AND (t1.b=t2.y OR false) AND t2.z=1 (aとbに索引あり、駆動表はt2、内部表はt1)
- bの索引は使用しません。aの索引を使用します。
3.2.5 ジョイン演算方法の決定方法
ジョインの演算方法には次の3つの種類があります。
| ジョインの演算方法 | 説明 |
|---|---|
| ハッシュジョイン | 駆動表の結合キーをハッシュ関数にかけてメモリ上に一時的なテーブルを作り、内部表のハッシュ値と一致するか比較して結合する方法です。 |
| ソートマージジョイン | 結合する2つのテーブルを結合キーでソートして、それらを順に比較して結合する方法です。 |
| ネステッドループジョイン | 駆動表の結合キーの値を元に、結合条件に合致する内部表のデータを探して結合する方法です。 |
速度が速いのは、ハッシュ、ソートマージ、ネステッドループの順です。
ジョインの第一結合条件の種類によって、これらの演算方法を選択します。
| 第一条件 | 選択する演算方法 |
|---|---|
| 等価条件 | ハッシュまたはソートマージジョイン (ハッシュが選択されていても、メモリリソースの制限により、部分的にソートマージに切り替わることがあります。V6.0以降、ワークメモリ上限を超える規模のハッシュジョインについては、大規模ジョインの最適化により大規模インメモリハッシュジョインが適用される場合があります。) |
| 大小条件 | ソートマージジョイン |
| なし | ネステッドループジョイン |
ジョインの第一結合条件は、次の優先順で選択します。
単純カラム式を優先して第一結合条件とします。
例)
t1.a=abs(t2.x)+10 AND t1.b=t2.y- 単純カラム式なので、t1.b=t2.yを第一条件とします。第一条件が等価条件なので、ハッシュまたはソートマージジョインを使用します。
単純カラム式が複数ある場合は、先に記述されている式を第一結合条件とします。
例)
t1.a>t2.x AND t1.b=t2.y- "t1.a>t2.x"と"t1.b=t2.y"は両方とも単純カラム式なので、記述順で"t1.a>t2.x"を第一条件とします。第一条件が大小条件なので、ソートマージジョインを使用します。
3.2.6 大規模ジョインの最適化
GridDB V6.0では、大規模データを対象としたジョイン処理の効率と安定性を向上させるため、大規模ジョインの最適化を追加しました。ここでは、その仕組みと適用条件、チューニングの考え方について説明します。
3.2.6.1 大規模インメモリハッシュジョイン
等価結合条件を持つジョイン処理では、結合対象のデータをメモリ上に展開してハッシュジョインを行います。従来は、左右の入力のいずれか(LEFTジョインの場合は右側)のデータサイズがワークメモリ上限(sql/workMemoryLimit)の範囲に収まらない場合、グレースハッシュジョインが選択され、中間データがSQL中間ストアへスワップされていました。この中間ストアへのスワップは、大規模データのジョインにおける性能低下の要因となります。
大規模インメモリハッシュジョインは、ワークメモリ上限を超えるメモリを用いてハッシュジョインをインメモリで実行することで、このスワップの発生を抑制します。これにより、大規模データを対象としたジョイン処理のスループットが向上します。
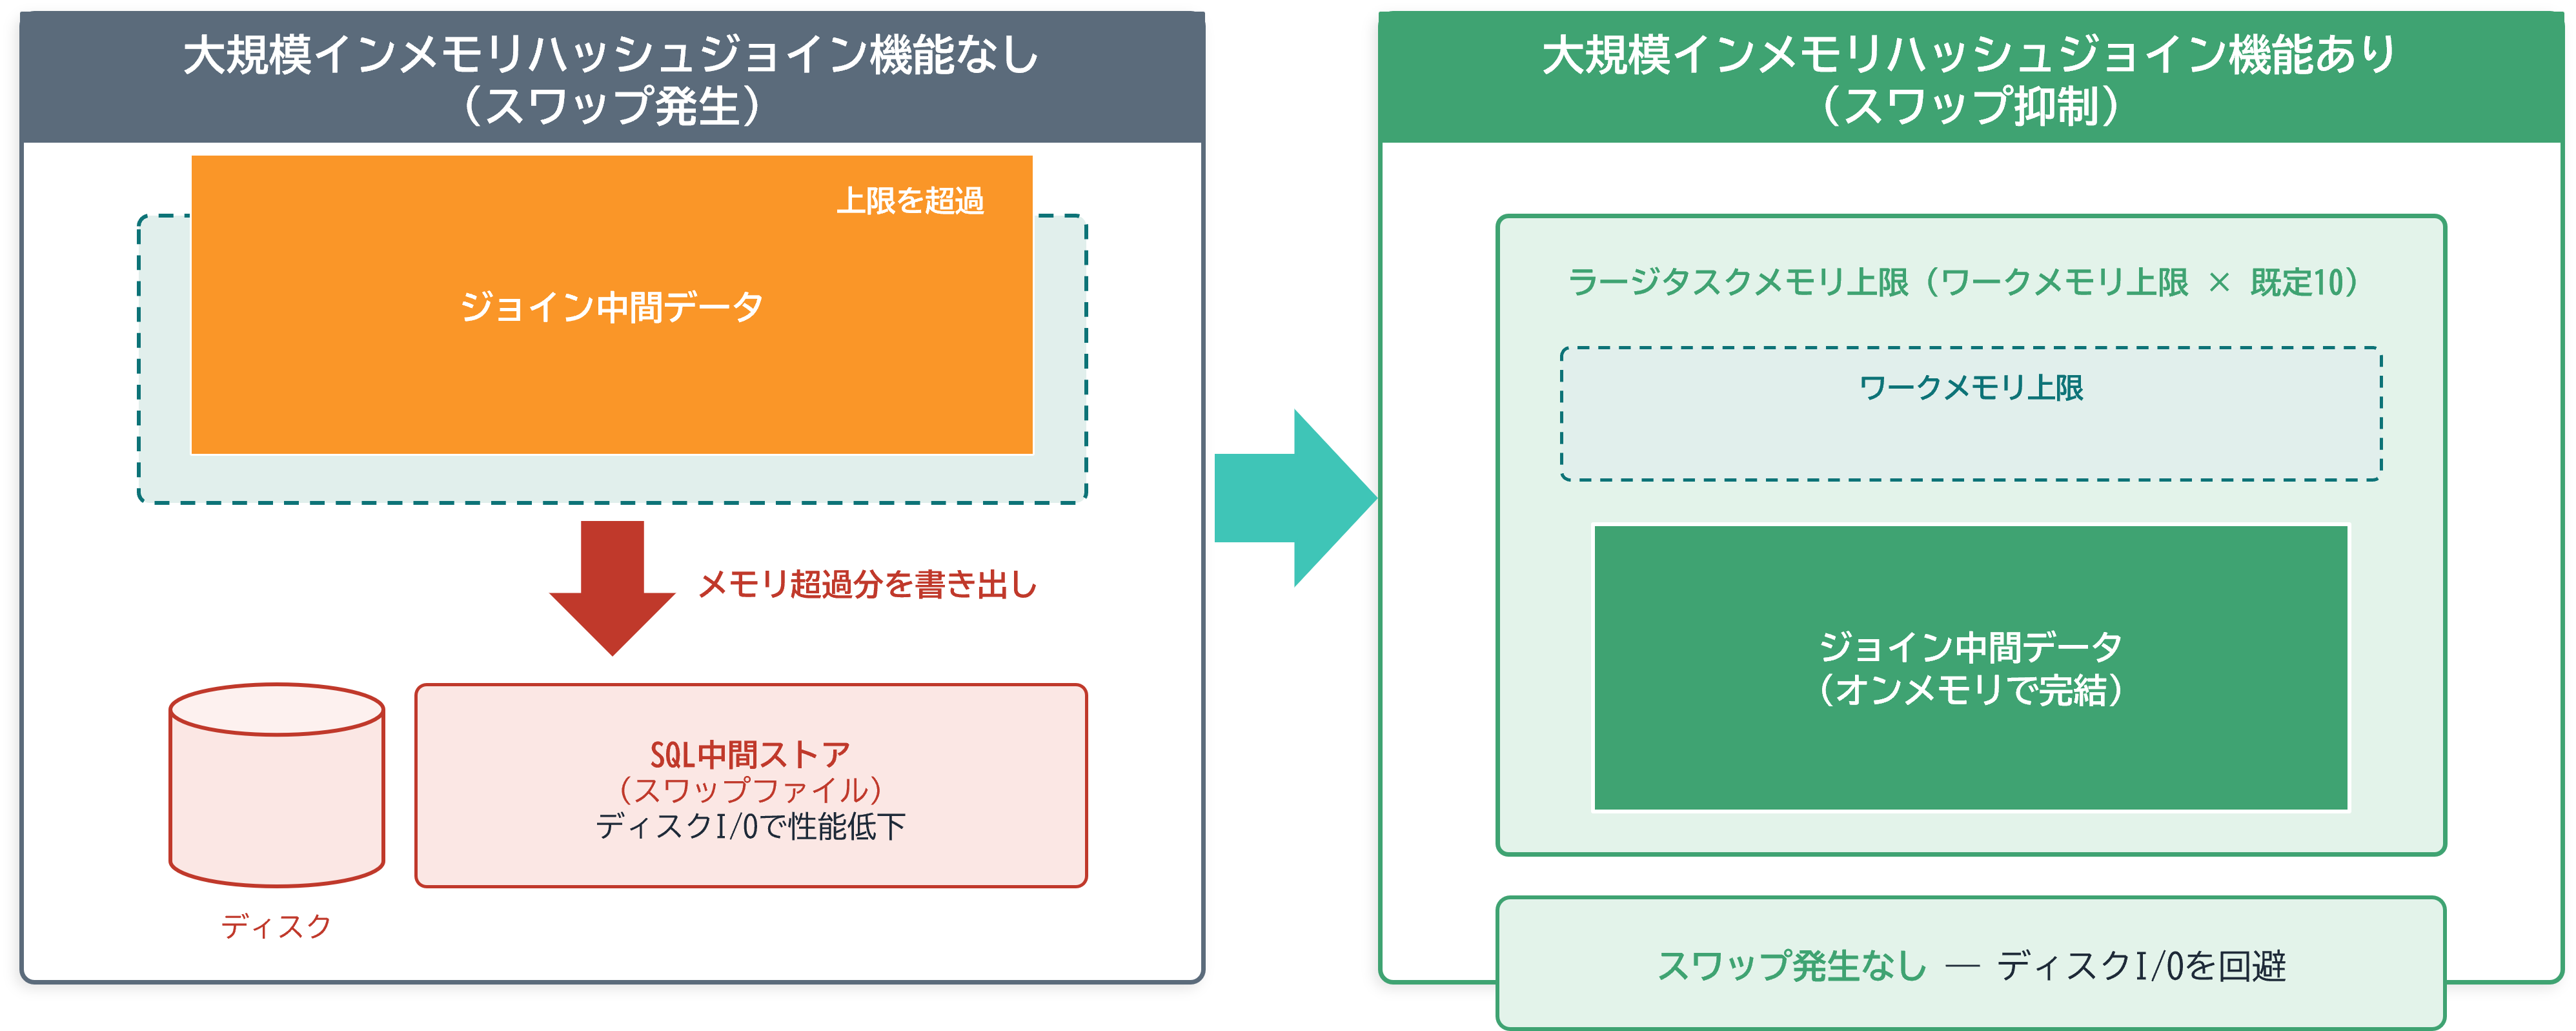
大規模インメモリハッシュジョインによるスワップ抑制(従来 vs V6.0)
- SQLの構文および実行結果(結果セット)は、本機能の適用有無によらず変化しません。
- 結合対象のカーディナリティやデータの偏りには依存せず、等価結合条件を満たす限り適用対象となります。
3.2.6.2 ジョイン処理方式の選択とメモリ消費特性
等価結合条件を持つジョインについて、入力データのサイズに応じて、次のようにジョイン処理方式が自動的に選択されます。ワークメモリ上限(sql/workMemoryLimit)およびラージタスクメモリ上限(後述)を基準とします。
| 入力データサイズ | 選択される方式 | スワップ |
|---|---|---|
| ワークメモリ上限の範囲に収まる | 通常のインメモリハッシュジョイン(従来どおり) | 発生しない |
| ワークメモリ上限を超過し、ラージタスクメモリ上限の範囲に収まる | 大規模インメモリハッシュジョイン | 発生しない |
| ラージタスクメモリ上限を超過する、またはラージタスクとしての実行が一定時間内に開始できない | グレースハッシュジョイン(従来どおり) | 発生する |
大規模インメモリハッシュジョインが選択されたタスクは「ラージタスク」として扱われます。ラージタスク1タスクあたりのメモリ上限(ラージタスクメモリ上限)は、ワークメモリ上限値を基準とした比率で指定します。
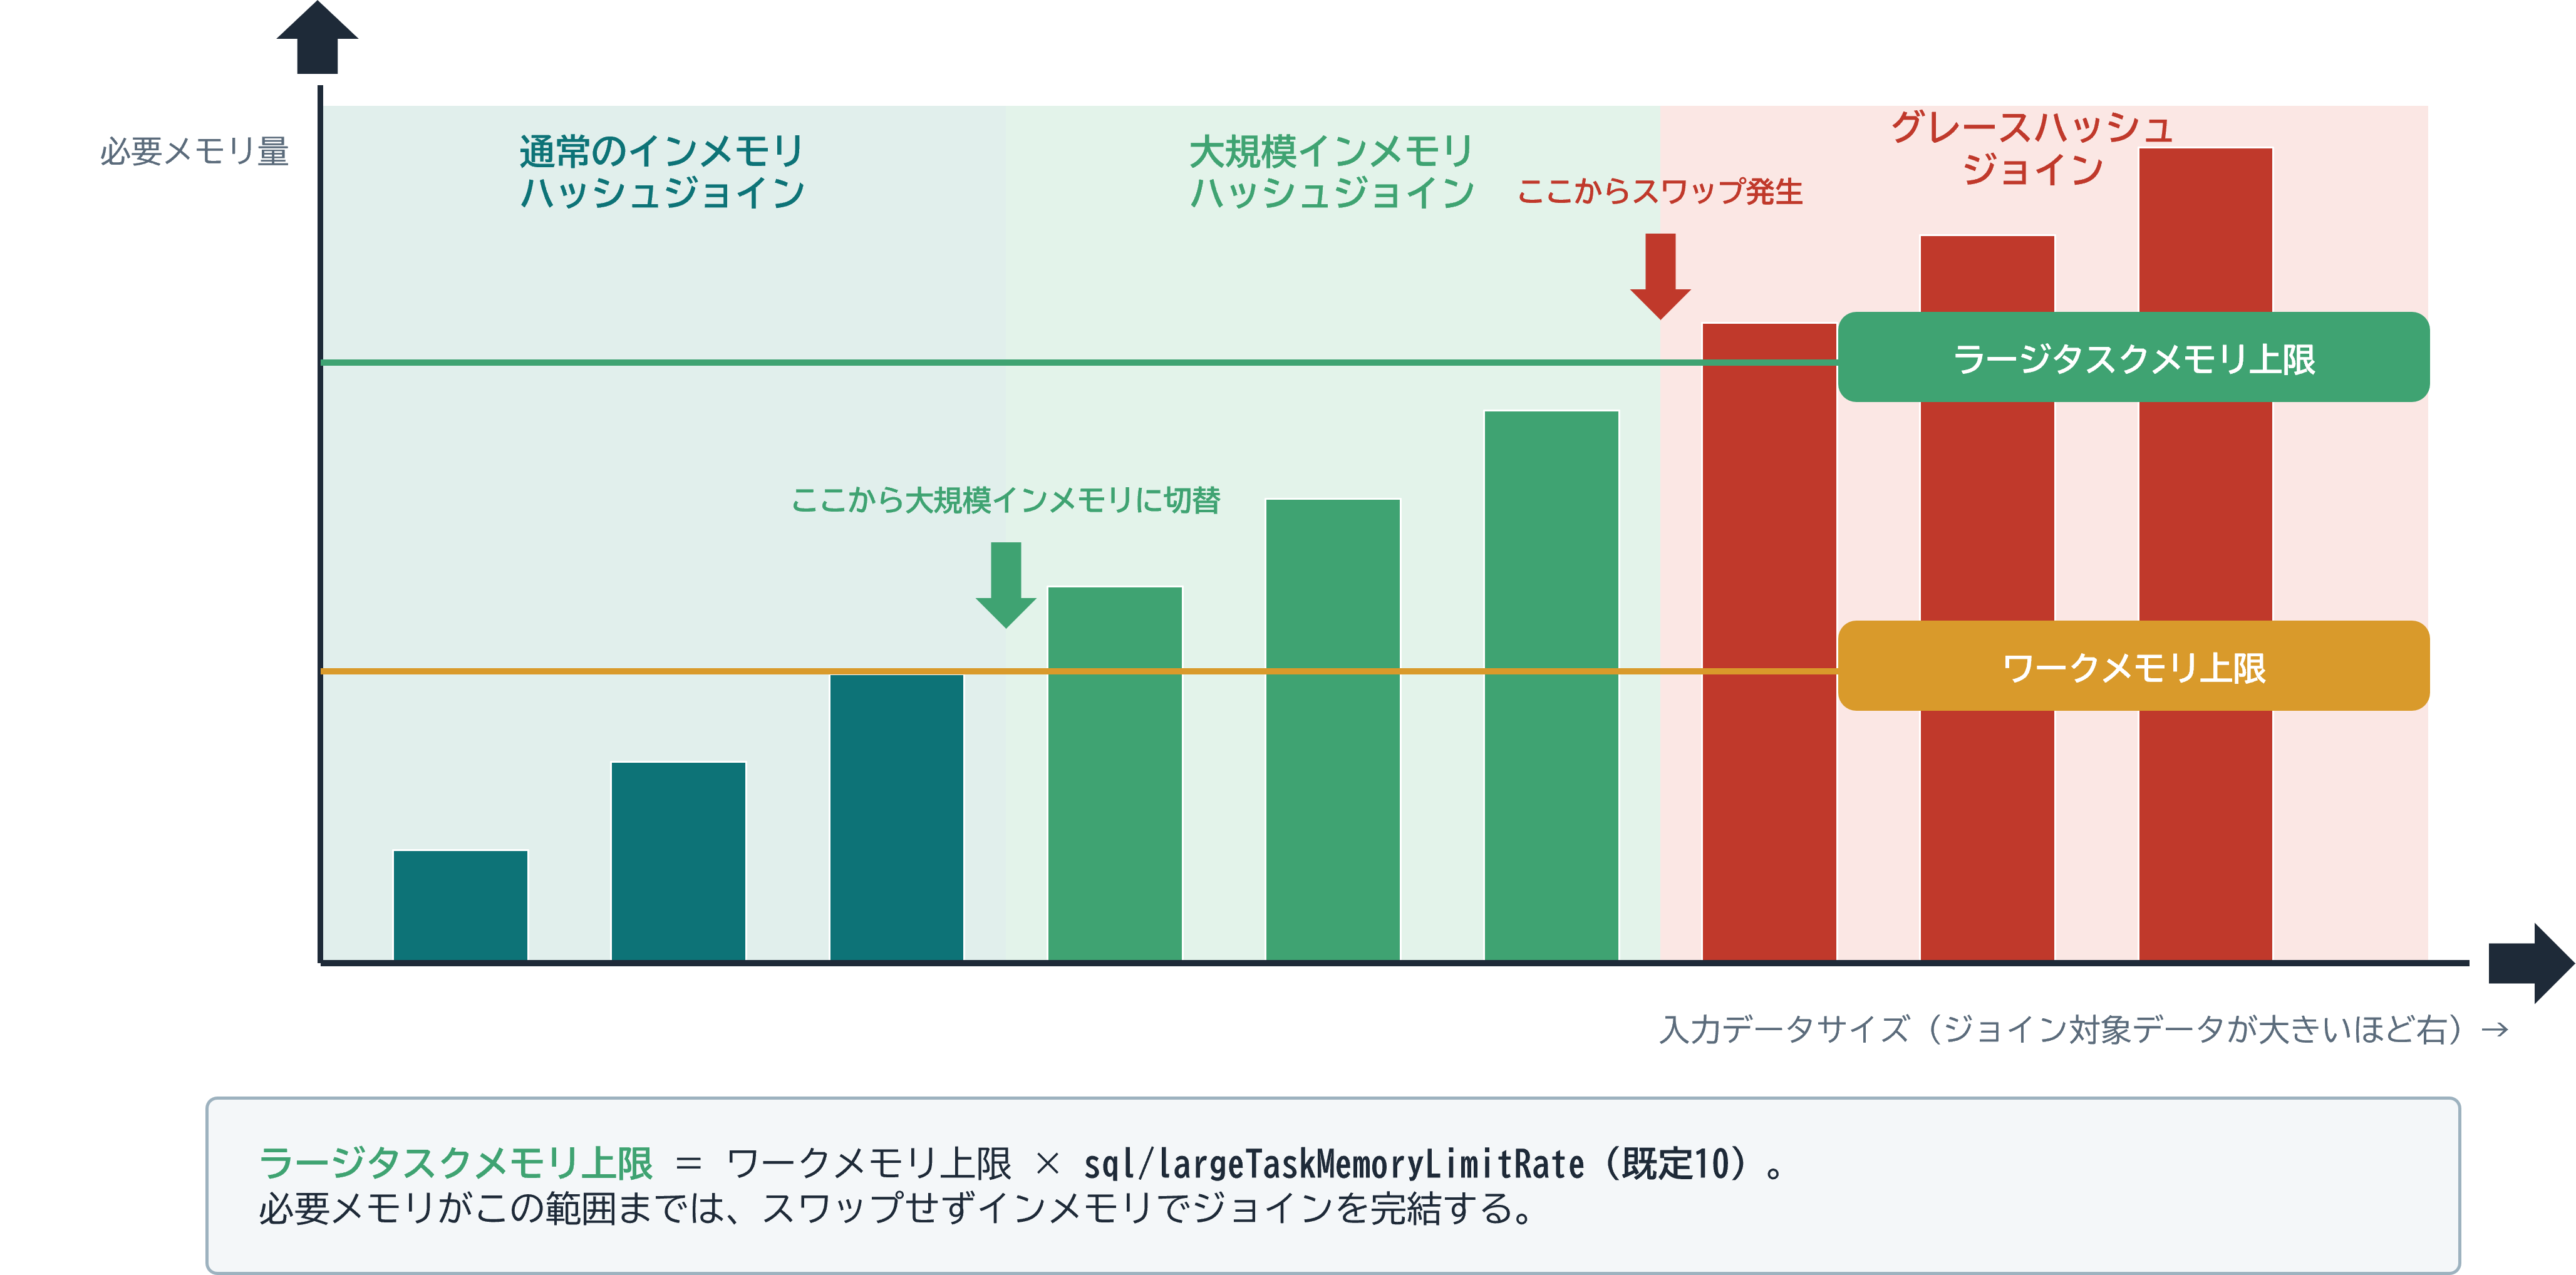
メモリ量に応じたジョイン処理方式の選択
3.2.6.3 同時実行制御
複数の大規模ジョインが同時に実行される場合、メモリの枯渇によるスワップの再発や処理失敗を防ぐため、ラージタスクの同時実行が制御されます。
- SQL処理で利用可能なメモリの制約により、複数のラージタスクをすべて同時に実行できない場合、実行開始が一時的に保留されます。
- 同一SQLジョブ内の複数のラージタスクは、原則として実行順が直列化されます。タスク間の依存関係により直列化できない場合は、通常タスクと同様にワークメモリ上限の範囲内で実行され、グレースハッシュジョインにフォールバックします。
- 異なるSQLジョブ間のラージタスクは、実行可能になるまで一定時間保留されます。一定時間経過後も実行可能にならない場合は、グレースハッシュジョインにフォールバックします。
3.2.6.4 設定パラメータ
大規模ジョインの最適化に関わる設定は、ノード定義ファイル(gs_node.json)の sql/largeTaskMemoryLimitRate です。ラージタスクメモリ上限を、ワークメモリ上限値(sql/workMemoryLimit)を基準とした比率で指定します。既定値は10です。値を大きくすると、より大規模なジョインを大規模インメモリハッシュジョインとして処理できますが、1タスクあたりのメモリ消費が増加します。詳細は『GridDB 機能リファレンス』(GridDB_FeaturesReference.html)のパラメータを参照してください。
チューニングの考え方は次のとおりです。EXPLAIN ANALYZEで largeTask 要素の criterion が OVER_SELF_LIMIT となり、大規模データのジョインでSQLスワップが発生している場合は、sql/largeTaskMemoryLimitRate を段階的に大きくすることで、大規模インメモリハッシュジョインの適用範囲が広がり、スワップを抑制できることがあります。ただし、値を大きくすると1タスクあたりのメモリ消費が増えるため、SQL処理全体のメモリ上限(sql/totalMemoryLimit)や同時実行するSQLの数を考慮し、他のクエリのメモリ不足を招かない範囲で調整してください。
【メモ】
- 大規模インメモリハッシュジョインが適用されているかどうか、およびラージタスクの待機状況は、EXPLAIN ANALYZEの実行プロファイルで確認できます。詳細はEXPLAIN ANALYZE 出力仕様(大規模ジョイン)を参照してください。
- パーティショニングテーブルを対象としたジョインで、並列分散化が優先され大規模インメモリハッシュジョインが適用されない場合は、
NoJoinExpansionヒントにより分散化を抑制できます。詳細はヒント句を参照してください。
3.2.7 EXPLAIN ANALYZE 出力仕様(大規模ジョイン)
GridDBでは、EXPLAIN ANALYZE 実行時に、SQLプランおよび実行プロファイルをJSON形式で出力します。この中に、大規模ジョインの適用状況に関する情報が含まれます。
等価結合条件を持つジョインタスク処理において、左右の入力のいずれか(LEFTジョインの場合は右側)のデータサイズがワークメモリ上限の範囲に収まらない場合、ジョインタスクを構成する JOIN オペレータの実行プロファイルに、要素 largeTask が出力されます。ワークメモリ上限の範囲内に収まる場合(通常タスクとして処理された場合)は、largeTask 要素は出力されません。
- 出力対象は、
JOINオペレータに対応するプロファイルです。
構成要素
| 要素名 | 説明 |
|---|---|
criterion |
JOINオペレータ内のマイクロプランの判断要素を示す文字列ラベル。値の意味は下表を参照。 |
estimatedMemory |
ワークメモリ上限を超過して、インメモリ処理に必要と推定されたメモリ使用量の推定値(単位: バイト)。インメモリ処理が受理されたかによらず、判定時点で到達済みのデータに基づき算出される。 |
pendingTime |
他のラージタスクによって実行を待機した場合の、待機時間の合計値(単位: ミリ秒)。 |
criterion の値
| 値 | 意味 |
|---|---|
LARGE |
各制約を満たし、ラージタスクとしてのマイクロプランが選定された(大規模インメモリハッシュジョインが適用された)。 |
OVER_SELF_LIMIT |
自タスクをラージタスクとする場合のメモリ使用量推定値が上限を超過したため、通常タスクとしてのマイクロプランが選定された(グレースハッシュジョインにフォールバック)。 |
OVER_TOTAL_LIMIT |
他のラージタスクを含めたメモリ使用量推定値が上限を超過したため、通常タスクとしてのマイクロプランが選定された(グレースハッシュジョインにフォールバック)。 |
【注意】
- 本出力形式および要素構成について、後継バージョンとの互換性は保証されません。
pendingTimeは、タスクのプロファイルにおけるleadTime要素の一部の時間に相当しますが、計測精度の制約により、常にleadTimeが大きくなるとは限りません。
出力例
{
  "profile": {
    "op": {
      "type": "JOIN",
      "largeTask": {
        "criterion": "LARGE",
        "estimatedMemory": 134217728,
        "pendingTime": 0
      }
    }
  }
}
3.3 ヒント句
実行計画を示すヒントをクエリに指定することで、SQL文を変えることなく実行計画を制御できます。
【注意事項】
- 本機能は将来のバージョンで変更される可能性があります。
3.3.1 用語
ヒント機能で用いる用語は次のとおりです。
| 用語 | 説明 |
|---|---|
| ヒント句 | 実行計画を制御するための情報 |
| ヒント | ヒント句を列挙したもの。実行計画を制御するクエリに指定する。 |
3.3.2 ヒントの指定方法
実行計画を制御するクエリのブロックコメントの中にヒントを記述します。ヒント用のブロックコメントは、 SQL文中の先頭のSELECT(INSERT/UPDATE/DELETE)句の直前または直後のみ記述できます。通常のコメントと区別するため、 ヒント用のブロックコメントは「/*+」で始めます。
ヒントの対象は、ヒント句の括弧内にオブジェクト名または別名で指定します。複数のオブジェクト名を指定する場合、 スペース、タブ、改行のいずれかで区切って指定します。
以下の例では、Leadingヒント句により、テーブル結合順序を指定しています。
/*+
Leading(t3 t2 t1)
 */
SELECT *
  FROM t1, t2, t3
    ON t1.x = t2.y and t2.y = t3.z
  ORDER BY t1.x
  LIMIT 10;
【メモ】
- クエリ中に同一名称のテーブルが複数回現れる場合、それぞれのテーブルに別名をつけて区別してください。
3.3.3 ヒント句一覧
指定できるヒント句の一覧を次に示します。
| 分類 | 命令 | 説明 |
|---|---|---|
| 並列化 | MaxDegreeOfTaskInput(上限数) | 1タスクへの入力の上限 |
| MaxDegreeOfExpansion(上限数) | プランノードの展開数の上限 | |
| スキャン方式 | IndexScan(テーブル) | 可能な場合はインデックススキャンを選択する |
| NoIndexScan(テーブル) | インデックススキャンを選択しない | |
| 索引選択 | CostBasedIndexScan() | コストベースによる索引選択を行う |
| NoCostBasedIndexScan() | コストベースによる索引選択を行わない(ルールベースによる索引選択を行う) | |
| ジョイン順序 | CostBasedJoin() | コストベースによるジョイン順序決定を行う |
| NoCostBasedJoin() | コストベースによるジョイン順序決定を行わない(ルールベースによるジョイン順序決定を行う) | |
| TableRowCount(テーブル ロウ件数) | コストベースによるジョイン順序決定のためのロウ件数概算値を与える(コストベースによるジョイン順決定を行う場合にのみ有効) | |
| 結合方式 | IndexJoin(テーブル テーブル) | 可能な場合はインデックスジョインを選択する |
| NoIndexJoin(テーブル テーブル) | インデックスジョインを選択しない | |
| 結合順序 | Leading(テーブル テーブル[ テーブル ...]) | 指定したテーブルを指定した順序で結合する |
| Leading(( テーブル集合 テーブル集合 )) | 1つ目に指定したテーブル集合を外部表、 2つ目に指定したテーブル集合を内部表として結合する |
|
| 並列分散化 | NoJoinExpansion(テーブル) | パーティショニングテーブルのジョインにおいて並列分散化を抑制する |
| 中間ロウ生成数 | MaxGeneratedRows(上限数) | GROUP BY RANGE句を用いた補間演算タスクで生成されるロウ数の上限 |
テーブル集合 = { テーブル or ( テーブル集合 テーブル集合 ) }
3.3.4 ヒント句詳細
ヒント句の分類ごとに詳細を説明します。
3.3.4.1 並列化
並列化処理の制御を行います。
- MaxDegreeOfTaskInput(上限数)
- 1タスクへの入力の上限数を指定します。以下の処理に適用されます。
- テーブルパーティショニングの設定されたテーブルをスキャンした場合のUNION ALL処理
- 1タスクへの入力の上限数を指定します。以下の処理に適用されます。
- MaxDegreeOfExpansion(上限数)
- プランノードの展開数の上限を指定します。以下の処理に適用されます。
- プッシュダウンジョイン最適化処理
- プランノードの展開数の上限を指定します。以下の処理に適用されます。
3.3.4.2 スキャン方式
テーブルのスキャン方式を指定します。
- IndexScan(テーブル)
- 可能な場合はインデックススキャンを選択します。元々インデックススキャンが不可能な場合は何もしません。
- NoIndexScan(テーブル)
- インデックススキャンを選択しません。
3.3.4.3 索引選択
クエリ実行時に利用する索引の選択方法を制御します。
- IndexSelectionCostBased
- コストベース方式で索引選択を行います。テーブルや索引の統計情報をもとに、最も効率的な索引やスキャン方法を自動的に選択します。
- IndexSelectionRuleBased
- ルールベース方式で索引選択を行います。主キーや先頭カラムの等価比較など、あらかじめ定められたルールに従って索引が選択されます。
3.3.4.4 ジョイン順序
3つ以上のテーブルが与えられた場合のジョイン順序の決定方法を指定します。
- CostBasedJoin()
- コストベースによる方法でジョイン順序を決定します。
- NoCostBasedJoin()
- コストベースによる方法を用いないで、ルールベースによる方法でジョイン順序を決定します。
- TableRowCount(テーブル ロウ件数)
- コストベースによるジョイン順序決定のためのコスト計算に用いるロウ件数の概算値を与えます。(ただし、コストベースによるジョイン順決定を行う場合にのみ有効です)
3.3.4.5 ジョイン駆動表
ジョイン駆動表の決定方法を指定します。
- CostBasedJoinDriving()
- コストベースによる方法で駆動表を決定します。
- NoCostBasedJoinDriving()
- コストベースによる方法を用いないで、ルールベースによる方法で駆動表を決定します。
【メモ】
- 同一のSQL文内で、コストベースのジョイン駆動表最適化の有効化・無効化ヒント両方の指定、この種別のヒントの複数回の指定はできません。
- コストベースのジョイン最適化全般に対するヒント指定(CostBasedJoin / NoCostBasedJoin)や関連するクラスタ設定が同時に設定された場合、コストベースのジョイン駆動表最適化の有効化・無効化ヒントの指定が優先されます。
- ジョイン方向に関するヒント指定(方向指定のLeadingヒント)が同時に指定された場合、該当するジョイン演算についてのみ、その指定に従うルールベースの最適化が適用されます。
3.3.4.6 結合方式
結合方式を指定します。
- IndexJoin(テーブル テーブル)
- 可能な場合はインデックスジョインを選択します。 元々インデックスジョインが不可能な場合は何もしません。
- NoIndexJoin(テーブル テーブル)
- インデックスジョインを選択しません。
3.3.4.7 結合順序
テーブルのジョイン処理でどのような順番で結合するかを指定します。
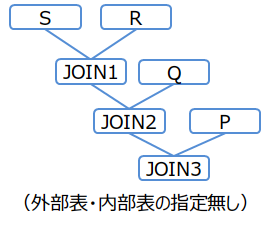
(1) 結合順序のみ指定: Leading(テーブル テーブル[ テーブル ...])
先に結合するテーブルから順にテーブル名または別名を指定します。この指定方式の場合、常にLeft-deep joinで結合されます。
(例1)
/*+ Leading(S R Q P) */
SELECT * FROM P,Q,R,S WHERE P.x = Q.x AND ...
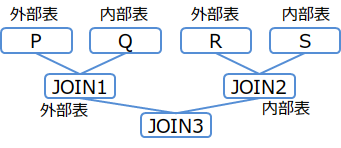
(2) 結合方向を含めた指定: Leading((テーブル集合 テーブル集合))
テーブル集合 = { テーブル or (テーブル集合 テーブル集合) }
(1)のように結合順序のみを指定した場合、結合方向(外部表/内部表の別)が期待と異なる場合があります。 結合方向を固定したい場合は以下の書式を使います。
/*+ Leading((t1 (t2 t3))) */
SELECT ...
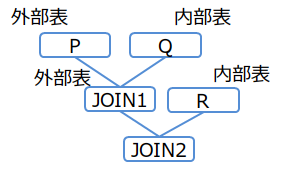
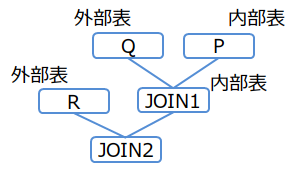
この書式では、括弧をネストして記述できます。括弧内の1つ目に指定したテーブル集合を外部表、 2つ目に指定したテーブル集合を内部表として結合されます。
(例2-1)
/*+ Leading(((P Q) R)) */
SELECT * FROM P,Q,R WHERE P.x = Q.x AND ...
(例2-2)
/*+ Leading((R (Q P))) */
SELECT * FROM P,Q,R WHERE P.x = Q.x AND ...
(例2-3)
/*+ Leading(((P Q) (R S))) */
SELECT * FROM P,Q,R,S WHERE P.x = Q.x AND ...
【メモ】
- 3つ以上のテーブルの結合で、テーブル間の結合条件が1つもない場合は、ヒントによる順序指定はできません。
3.3.4.8 中間ロウ生成数
1タスクが中間生成するロウ数の上限を設定します。GROUP BY RANGE句を用いた補間演算タスクに適用されます。
- MaxGeneratedRows(上限数)
- 上限数は、1タスクが生成する中間結果のロウ数に対する設定値です。以下の処理に適用されます。
- GROUP BY RANGE句を用いた補間演算を行うタスク
- SQL実行の結果、最終的に得られるロウ数は複数タスクの合計となるため、この設定値より大きくなることがあります。
- 上限数は、1タスクが生成する中間結果のロウ数に対する設定値です。以下の処理に適用されます。
3.3.4.9 並列分散化の抑制
パーティショニングテーブルを対象としたジョインにおいて、並列分散化を抑制し、大規模インメモリハッシュジョインの適用を促します。
- NoJoinExpansion(テーブル)
- 指定したパーティショニングテーブルについて、ジョイン処理における並列分散化を抑制します。
パーティショニングテーブル同士のジョインでは、自動選択により並列分散化が優先される場合があります。分散化によってタスクあたりのデータサイズが縮小し、各タスクがワークメモリ上限の範囲内で処理される一方、分散に伴うオーバヘッドやSQLスワップが多発するケースがあります。このような場合に本ヒントで分散化を抑制すると、大規模インメモリハッシュジョインが選択され、スワップを回避できることがあります。
example
/*+ NoJoinExpansion(table1) */ SELECT * FROM table1, table2 WHERE table1.x = table2.y;
【メモ】
- 本ヒントを指定した場合としない場合とで、SQLの実行結果(結果セット)は一致します。
- 大規模インメモリハッシュジョインの適用状況は、EXPLAIN ANALYZEの
largeTask要素で確認できます。詳細はEXPLAIN ANALYZE 出力仕様(大規模ジョイン)を参照してください。
3.3.5 エラーの扱い
以下の場合は構文エラーとなります。
- ヒント用のブロックコメントを複数記述した場合
- ヒントを記述できない位置にヒントを記述した場合
- ヒント句の記述に構文上の誤りがあった場合
- 同じテーブルに対して同じ分類のヒント句を重複して指定した場合
以下の場合はテーブル指定エラーとなります。
- ヒント句対象のテーブル指定に誤りがあった場合
【メモ】
- テーブル指定エラーが起こった場合、対象のヒント句を無視し、それ以外のヒント句を使ってクエリを実行します。
- 構文エラーとテーブル指定エラーが同時に起こった場合は構文エラーとなります。
4 SQLのプラン(実行計画)
SQL最適化によってどのような演算や索引が選択されたかは、SQLのEXPLAIN ANALYZE文で確認することができます。
SQLの処理では、SQL構文を解析して最適化し、ジョインやソート・スキャンなどの複数の「タスク」という処理単位に分解してプラン(実行計画)を生成します。
タスクは、クラスタを構成するノードのいずれかひとつで実行され、タスク間でデータのやり取りをしながら並列実行します。
[メモ]
- SQL最適化によるプランが適さない場合は、ヒントを用いてプランを変更することができます。詳細はヒント句をご参照ください。
EXPLAIN ANALYZE文を実行すると、タスクのプランや実行時間などの情報を、タスク単位で1行ごとにJSON形式で出力します。
出力する主な項目は以下の通りです。
| 項目 | 説明 |
|---|---|
| id | プランID |
| type | 処理の種類 |
| inputList | 入力値となるプランのプランIDの列 |
| profile/plan | (コストベースによるジョイン順決定を行った場合)プラン生成時に推定したコスト情報 |
| profile/leadtime | 処理時間 |
| profile/rows | 入力件数 |
| profile/address | 処理を実行したノードのアドレスとポート番号 |
[メモ]
- 入力件数はタスク間の制御情報の伝搬タイミングなどに応じて変動する可能性があります。
処理の種類は以下の通りです。
| typeの値 | 説明 |
|---|---|
| GROUP | グルーピング演算 |
| JOIN | ジョイン演算 |
| LIMIT | 行単位件数フィルタ演算 |
| SCAN | テーブルスキャン演算 |
| SELECT | 選択演算(条件フィルタ・プロジェクション) |
| SORT | ソート演算 |
| UNION | 連結・集合演算 |
| INSERT、UPDATE、DELETE | 各種コンテナ変更操作 |
| DDL | DDL・DCL文相当 |
| RESULT | 結果の保持 |
プランは、運用ツールgs_shで取得することができます。
例) クエリ「select * from table1, table2 where table1.value=0 and table1.id=table2.id」のプラン取得
gs[public]> EXPLAIN ANALYZE select * from table1, table2 where table1.value=0 and table1.id=table2.id;
検索を実行しました。 (11 ms)
gs[public]> getplantxt
Id Type       Input Rows Lead time Actual time Node                 And more..
--------------------------------------------------------------------------------------------------------------------
 0 SCAN       -     -            0           0 192.168.15.161:10001 table: {table1} INDEX SCAN
 1   SCAN     0     0            2           2 192.168.15.161:10001 table: {table1, table2} INDEX SCAN JOIN_EQ_HASH
 2     RESULT 1     0            0           0 192.168.15.161:20001
gs_shでサブコマンドgetplanjsonを実行すると、プランをJSON形式で出力することもできます。
[注意]
- プランのJSON形式は、今後のバージョンでデータ構造が変わる可能性があります。
例) プランのJSON形式の例
{
  "nodeList" : [ {
    "cmdOptionFlag" : 65,
    "id" : 0,
    "indexInfoList" : [ 3, 3 ],
    "inputList" : [ ],
    "outputList" : [ {
      "columnId" : 0,
      "columnType" : "INTEGER",
          :
          :
}